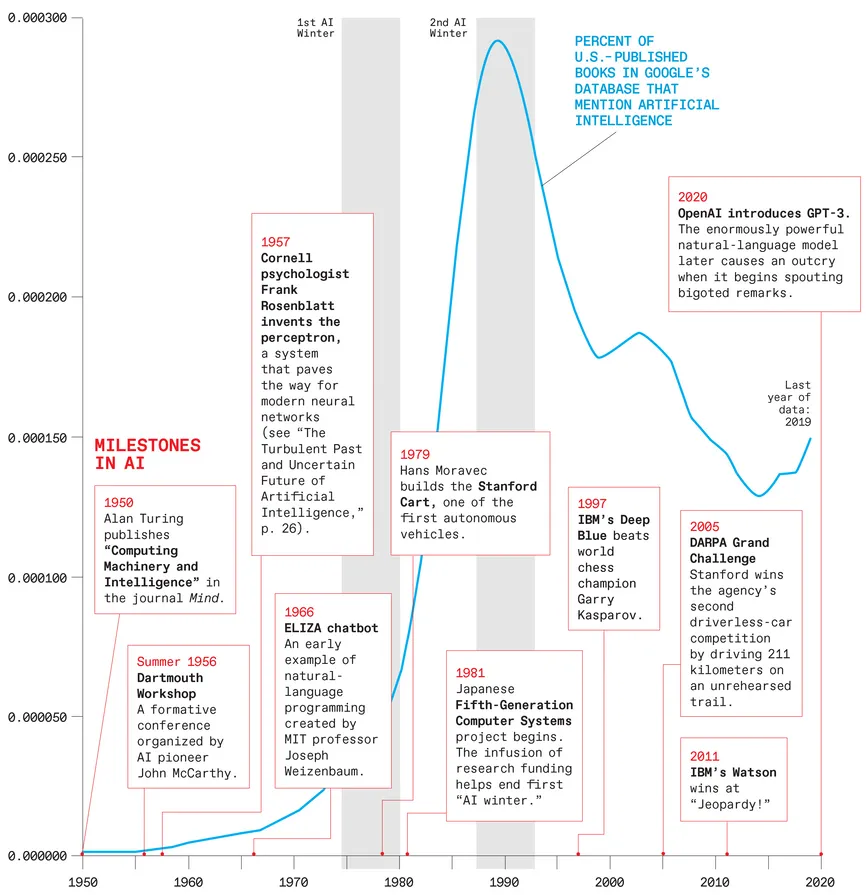
Модерният напоследък изкуственият интелект (AI) е технология захранвана от т.н. невронни мрежи. Те не са нещо ново в науката, за първи път се споменават през 50-те, а през 80-те години придобиха най-голяма популярност. Днес, просто някои бизнес фактори са решили да пуснат за свободно ползване разработени продукти, захранвани от тях. Тези форми на Ai се основават на логически алгоритми за обучение използващи символни разсъждения.
Какво представлява една невронна мрежа?
Невронната мрежа дава правилния отговор на проблем, като минимизира функцията за загуба. Да предположим, че имаме това просто линейно уравнение: y = mx + b. То прогнозира някаква стойност на y при дадени стойности на x. Прогнозните модели не винаги са 100% правилни. Мярката за това колко е неправилна е загубата. Целта на машинното обучение е да се вземе набор от обучения, за да се сведе до минимум функцията за загуба. Това е вярно за линейната регресия. Да предположим например, че m = 2, x = 3 и b = 2. Тогава нашата прогнозирана стойност на y = 2 * 3 + 2 = 8. Но нашата действителна наблюдавана стойност е 10. Така че загубата е 10 – 8 = 2.
В невронната мрежа имаме същия основен принцип, с изключение на това, че входовете и изходите са двоични. Обектите, които правят изчисленията се наричат неврони. Те се настройват, за да сведат до минимум функцията за загуба, докато моделът не стане много точен. Например, можем да получим анализ на почерка, за да бъдем 99% точни.
Невронните мрежи са проектирани да работят точно като човешкия мозък. В случай на разпознаване на почерк или разпознаване на лица, мозъкът много бързо взема някои решения. Например, в случай на лицево разпознаване, мозъкът може да започне с „Това е жена или мъж? Черно или бяло е? Стара ли е или млада? Има ли белег?“ и т.н. Всички тези входове (x1, x2, x3) се подават в неврон. Това след това взема решение „да“ или „не“ и го предава на следващия перцептрон за следващото решение. Този процес се повтаря до крайния неврон.
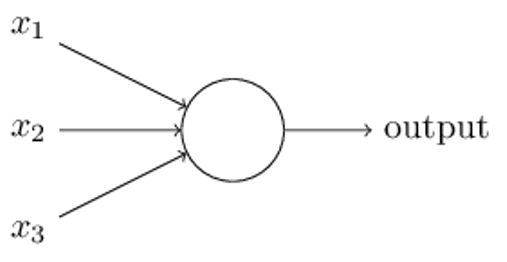
Невронът е обект, който приема двоични входове и изходи двоичен изход. Той използва претеглена сума и праг, за да реши дали резултатът трябва да бъде да (1) или не (0). Например, да предположим, че искате да отидете във Франция, но само ако:
- x1 -> Самолетният билет е по-малко от 1 долара.
- x2 -> Вашата приятелка или гадже може да дойде с вас.
Вие представяте това решение с този прост вектор от възможни входове:
(1,0), (0,1), (1,1) и (0,0).
В първия случай (1,0) билетът е > 1 и вашата приятелка или гадже не може да отиде с вас.
Вие поставяте някаква тежест на всяко от тези две изчисления. Например, ако сте на бюджет и цената е важна, дайте му тегло w1=4. И дали партньорът ви може да отиде или не, не е толкова важно. Така че дайте му тегло w2 = 3.
Така че имате тази функция за Отидете във Франция:
(x1 * w1) + (x2 * w2) = (x1 * 4) + (x2 * 3) > някакъв праг, b, да речем, 4.
Преместваме b от другата страна и пишем:
Ако (x1 * 4) + (x2 * 3) -4 > 0 тогава отидете във Франция (т.е. perceptron казва 1)-
След това подайте вектори в уравнението. Очевидно е, че ако билетът е > $ 1,000 и ако приятелката ви не може да отиде (0,0), тогава няма да направите пътуването, защото
(0 * 3) + (0 * 4) – 4 очевидно е < 0.
Ако билетът е евтин, но отивате сами, тогава отидете така или иначе:
(1 * 4) + (0 * 3) – 4 = 0, което не е по-голямо от 0.
Разпознаване на ръкописен текст с невронни мрежи
Почеркът и лицевото разпознаване с помощта на невронни мрежи прави същото, което означава да се вземат поредица от двоични решения. Това е така, защото всяко изображение може да бъде разбито на най-малки обекти, пиксели. В случай на определен почерк пикселите се различават, защото всеки пиксел е черен (1) или бял (което означава празен или 0). Невронната мрежа сумира своите входове и прилага активираща функция, за да определи изхода си. Тази архитектура е вдъхновена от това, което се случва в мозъка, където невроните предават сигнали помежду си чрез синапси.
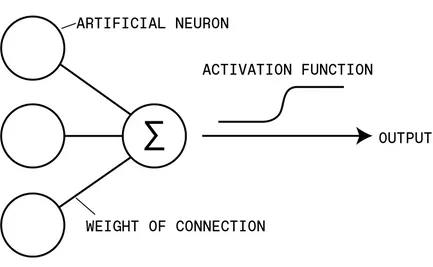
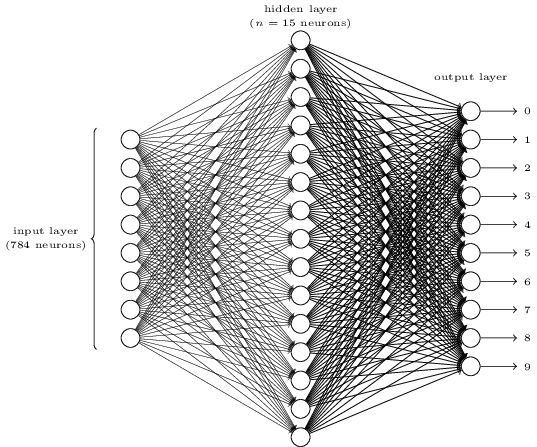
Deep-learning включва дълбока невронна мрежа („дълбока“, защото съдържа множество скрити слоеве). Този пример показва мрежа, която интерпретира изображения на ръчно написани цифри и ги класифицира като една от 10-те възможни цифри. Входният слой съдържа много неврони, всеки от които има активиране, настроено на стойността на сивата скала на един пиксел в изображението. Тези входни неврони са свързани с невроните в следващия слой, предавайки нивата им на активиране, след като са били умножени по определена стойност, наречена тегло. Всеки неврон във втория слой сумира многобройните си входове и прилага активираща функция, за да определи изхода си, който се подава напред по същия начин.
Обучение за невронни мрежи
С изкуствения интелект тренираме невронната мрежа, като променяме теглата x1, x2, x3, … , xn и пристрастията b. Това означава, че променяме входовете, за да сведем до минимум функцията за загуба. Това не е по-различно от простата линейна регресия. Не забравяйте, че функцията за загуба е само разликата между прогнозираната стойност и наблюдаваната стойност. Когато има само 1 или 2 входа, това е лесно. Но с разпознаването на ръкописен текст има стотици или хиляди входове. (За изображение от 256 пиксела има 256 * 256 входа в нашата невронна мрежа, изглежда нещо подобно, с изключение на това, че това е направено по-малко, за да можете да го визуализирате. И тази мрежа гледа само цифрите, а не цялата азбука.)
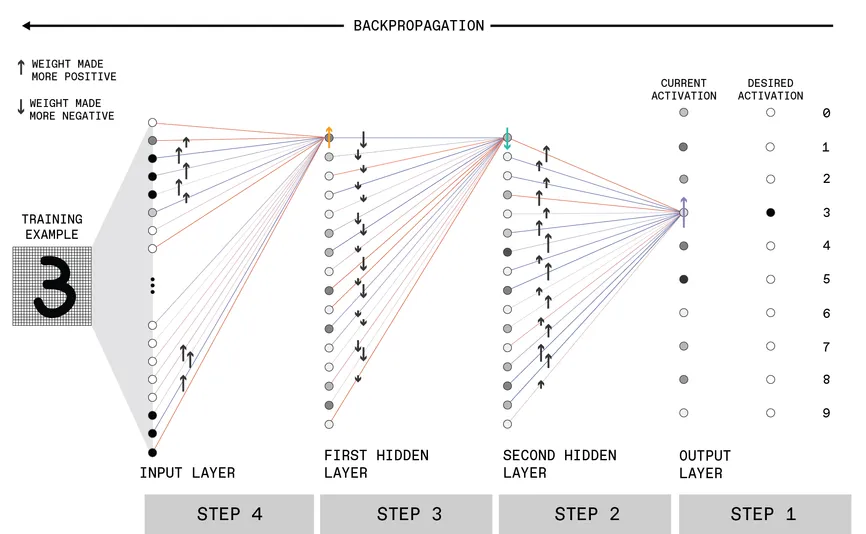
Tози вид невронна мрежа се обучава чрез изчисляване на разликата между действителния изход и желания изход. Задачата за математическа оптимизация тук има толкова измерения, колкото са регулируемите параметри в мрежата – предимно теглата на връзките между невроните, които могат да бъдат положителни [сини линии] или отрицателни [червени линии].

Обучението на мрежата по същество намира минимум от тази многомерна функция „загуба“ или „цена“. Това се прави итеративно в продължение на много тренировъчни писти, като постепенно променя състоянието на мрежата. На практика това предполага извършването на много малки корекции на теглата на мрежата въз основа на изходите, които се изчисляват за случаен набор от входни примери, като всеки път се започне с тежестите, които контролират изходния слой и се движи назад през мрежата. (Тук са показани само връзките към един неврон във всеки слой, за простота.) Този процес на обратно разпространение се повтаря в много случайни набори от примери за обучение, докато функцията за загуба не бъде сведена до минимум и мрежата след това осигурява най-добрите резултати, които може за всеки нов вход.
СТЪПКА 1
Когато са представени с ръкописно „3“ на входа, изходните неврони на нетренирана мрежа ще имат случайни активации. Желанието е изходният неврон да се свърже с 3, да има висока активация [тъмно засенчване] и други изходни неврони да имат ниски активации [светло засенчване]. Така че активирането на неврона, свързан с 3, например, трябва да се увеличи [лилава стрелка].
СТЪПКА 2
За да направите това, теглото на връзките от невроните във втория скрит слой към изходния неврон за цифрата „3“ трябва да бъде направено по-положително [черни стрелки], като размерът на промяната е пропорционален на активирането на свързания
скрит неврон.
СТЪПКА 3
След това подобен процес се извършва за невроните във втория скрит слой. Например, за да се направи мрежата по-точна, може да се наложи активирането на горния неврон в този слой да бъде намалено [зелена стрелка]. Мрежата може да бъде избутана в тази посока чрез регулиране на теглата на връзките си с първия скрит слой [черни стрелки].
СТЪПКА 4
След това процесът се повтаря за първия скрит слой. Например, първият неврон в този слой може да се наложи да увеличи активирането си [оранжева стрелка].
При проста линейна регресия функцията на загубата е разстоянието между наблюдаваната стойност z и прогнозираната стойност p, или z – p. При невронните мрежи използваме нещо по-сложно, наречено стохастично градиентно спускане, което не е необходимо да се разбира. Достатъчно е да се каже, че в общи линии е едно и също нещо. Но намирането на минималната стойност в някаква функция с хиляди входни променливи е трудно постижимо, така че стохастичното градиентно спускане първо прави предположение и след това работи оттам.
Майкъл Нилсен дава тази аналогия. По-долу е дадена графика на функция за загуба f(x,y), т.е. функция с два входа. Ако пуснете мрамор в тази купа, той ще се търкаля до най-ниската точка. Стохастичното градиентно спускане е алгоритъм за намиране на тази точка за функция на загуба с много входни променливи. (За тези, които знаят смятане, може да се каже защо просто не вземете производната на тази функция и не намерите нейния минимум? Отговорът е, че не можете лесно да намерите производната за функция с хиляди променливи.)
Разпознаване на изображения с невронни мрежи
Невроните са прости линейни уравнения с изход 1 (вярно) или 0 (невярно). Точно този пример не е удачен при задачи за разпознаване на изображения, защото малките промени в теглата и пристрастията водят до големи промени в изхода. В края на краищата за тази цел се използват коефициенти, например 0,2 до 0,65. Да предположим, че имаме проста невронна мрежа с две входни променливи x1 и x2 и отклонение от 3 с тегла – 2 и -3. Уравнението за това е:
Ако -2×1 + -3×2 + 3 < 0, тогава 1 (вярно) в противен случай 0 (невярно).
(Това не е точно правилният начин да се изрази това в алгебрата, но е нагледен пример. Целта тук е да се сведе математиката до минимум, за да стане по-лесна за разбиране.)
Машинното обучение регулира теглата и отклоненията, докато получената формула най-точно изчислява правилната стойност. Не забравяйте, че това е все едно да кажете, че коригирането на тежестите и пристрастията намалява функцията за загуба до нейния минимум. Повечето проблеми с ML работят например с линейна регресия.
И така, как да избегнем голямата промяна от 0 към 1, което би объркало нашия модел? Позволяваме входни и изходни числа между 0 и 1 вместо само 0 или 1. Най-простият начин да направите това е да разделите уравнението на числото 1, като използвате подобна формула, като тази, използвана от логистичната регресия. И тогава приемаме конвенцията, че ако крайната изходна стойност на невронната мрежа има праг, да речем 0,5, тогава можем да заключим, че резултатът е 1.
Но не е ли това просто заобиколен начин за изчисляване на нещо, което води до 0 или 1? Не. Защото в невронната мрежа няма само входните начални стойности и получения изход. В средата има междинни стъпки, наречени скрити слоеве. Те не трябва да се оценяват на 0 или 1.
Както и да е, нека сега видим как работи това с разпознаването на ръкописен текст. Ето изображение на числото „0“. Невронната мрежа разглежда всеки пиксел и колко тъмен е пикселът, за да разбере кои пиксели са попълнени. След това сръвнява това с образци на почерк, за които е известно, че представляват числото 0. Тренировъчният комплект взема образци например от 350 души. Тези данни вземат комбинацията от пиксели на всеки чертеж и показват дали е 0, 1, 2, …, или 9. След това невронната мрежа се обучава, въз основа на тези данни, т.е. коригира коефициентите и пристрастията, докато най-точно определи коя е цифрата.
AI, като инструмент в националната сигурност
Комбинирането на AI с байесовски разсъждения може да помогне за прогнозиране на събития без исторически опит за анализ
едки бедствия от типа „черен лебед“ като земетресения или пандемии, които се оказаха трудни за прогнозиране, могат да станат предвидими с помощта на AI, открива ново проучване.
Необичайни събития като измамни вълни или горски пожари могат да имат тежки последици. Въпреки това, тяхната рядкост означава, че има малко исторически данни за прогнозни модели, които да анализират, за да прогнозират точно кога могат да се случат в бъдеще. Освен това тези събития често изглежда възникват от неизвестен набор от физически условия, което прави прогнозирането им аналогично на намирането на игла „в безмерна купа сено“, отбелязва проучването.
Сега изследователите предложиха нова стратегия за преодоляване на тези предизвикателства. Той обединява AI, който обикновено разчита на тонове данни за обучение, със статистическия подход, известен като Bayesian reasoning, при който предварителното знание помага да се изчислят шансовете, че несигурният избор може да е правилен.
Целта на тази комбинация е да се определи кои биха могли да бъдат най-полезните данни, когато става въпрос за точни прогнози за редки събития. Въпросът е да се възползваме максимално от оскъдните данни. По същество качеството на точките от данни може да помогне да се компенсира липсата на количество, което потенциално позволява да се направи повече с по-малко.
„Обикновено AI се нуждае от изобилни данни, за да бъде успешен“, казва водещият автор на изследването Итън Пикъринг, изследовател в областта на машинното обучение, сега в Bayer Crop Sciences в Кеймбридж, Масачузетс. „С нашия подход са необходими само малко количество внимателно подбрани данни, за да се осигурят точни и надеждни резултати.“
Предишни изследвания за прогнозиране на екстремни събития се фокусираха върху разработването на уравнения за правилно моделиране на сложните системи, които пораждат тези събития. Въпреки това, „управляващите уравнения на тези системи са изключително чувствителни към шума и предположенията, което означава, че дори внимателно изработените модели, базирани на физиката, често се провалят и са невъзможни за прилагане на практика“, казва Пикъринг. Още по-лошо, тези управляващи уравнения „обикновено са неизвестни за системите от реалния живот, за които ни е грижа, оставяйки ни без физични методи, за да разберем тези явления“
Вместо това учените разчитаха на AI системи, които правеха прогнози въз основа просто на данни. „AI предоставя гъвкава възможност да прескочим това фундаментално предизвикателство, основано на уравнения, и да базираме разбирането си за тези системи на наблюдаваната истина“, казва Пикъринг. „Препятствието в това обаче е, че се нуждаем от достатъчно данни, за да може AI ефективно да разбере сложната система, която искаме от нея да моделира.“
В новото проучване изследователите експериментират с дълбока невронна мрежа, наречена DeepONet. Невронната мрежа е съставена от изчислителни възли, свързани заедно по начин, който грубо имитира връзките между невроните в човешкия мозък. Невронната мрежа се нарича „дълбока„, ако притежава няколко слоя възли.
По-конкретно, DeepONet е дълбок невронен оператор. Тази разновидност на AI системата се състои от две невронни мрежи в една, обработващи данни в две паралелни мрежи. Тази архитектура му помага ефективно да научи как работят физическите системи.
„Използването на ансамбъл от дълбоки невронни оператори води до количествено определяне на несигурността, което позволява на нашия подход да работи добре“, казва Пикъринг.
Учените отбелязват, че техният подход помага да се анализират рисковете от редица редки сценарии, включително оценка на шансовете за опасни пикове на случаите по време на пандемия, откриване кои привидно доброкачествени вълни могат да доведат до опасни измамни вълни и оценка кога корабът може да се счупи наполовина поради стрес.
Пикеринг и колегите му открили, че новият им метод превъзхожда традиционните усилия за моделиране, когато става въпрос за прогнозиране на тези събития. „Бяхме просто изненадани колко добре работи нашият подход за всяка система, която опитахме, включително много, които не са описани в статията, както и много сложни системи“, казва Пикъринг.
В бъдеще учените биха искали да използват стратегията си, за да помогнат за прогнозирането на бедствия, които днешните компютърни модели предполагат, че ще дойдат с изменението на климата.
„Ще дам актуален пример, тъй като тази година, 2023 г., очакваме Ел Ниньо да инициира значително увеличение на екстремните метеорологични събития, а именно урагани“, казва Пикъринг. Стратегията на изследователите, заедно с компютърните модели на ураганите, може да помогне за „ефективно разкриване на вероятните и катастрофални сценарии, за които обществото трябва да се подготви през 2023 г.“ и „може да се използва и за откриване на оптималните сценарии за смекчаване на екстремните събития, които сега са изключително полезни за справяне с входящите бедствия“.
Предизвикателство, пред което са изправени изследователите, когато става въпрос за прогнозиране на бедствия, свързани с изменението на климата, е „дали проблемите, от които се интересуваме, просто все още са твърде сложни“, предупреждава Пикъринг. „Дори ако намалим количеството данни, необходими за разбирането на системата, това количество данни [което е необходимо] все още може да е твърде много, за да ги генерираме. Въпреки това, с много квалифицирани учени, работещи с алгоритми като нашия, може да успеем да намалим сложността по подходящ начин и да намерим работещи решения на нашите големи климатични предизвикателства. „
Препоръчана литература: 2023.05_Natalia_Marinova.pdf (eknigibg.net)
ААААААААААА