Етичните хакери наричат разузнаването „Footprinting“. Това е първата фазата за проникване в даден сайт. В нея се събира полезна информация за целта на атаката. Целта може да бъде, дигиталния отпечатък на даден човек, уебсайт или приложение. Разузнаването може да се извършва активно или пасивно. В тази статия ще проследим начините за пасивно разузнаване на уебсайтовете, чрез техния DNS отпечатък, whois, използвайки търсачките, социалните мрежи и т.н.
1. Започваме с обикновено разглеждане на уебсайта (набелязаната цел). Тук събираме информация за различни детайли. Коя е версията на използвания софтуер, подробности за ОС, поддомейни, имена на файлове и път до файла, скриптове или вид на CMS, който се използва, данни за контакт и др. Може да разберете IP на даден сайт, като отворите командния промт и просто изпишете ping ime-site.com. След това да вземете IP и да направите търсене за него в Bing, това ще ви даде и другите сайтове, които се намират на този хост.

2. Whois търсене. Това е начин за проверка на информация за собствеността на домейна, намиране на подробности с данни за контакт със собственика на домейна, дата на регистрация и изтичане на домейна, както и свързани имена на домейни. Това е протокол, който се използва широко в подкрепа на заявки за бази данни, които съхраняват регистрираните потребители или правоприемници на интернет ресурс, като име на домейн, блок от IP адреси или автономна система, но се използва и за по-широк спектър от друга информация. Протоколът съхранява и доставя съдържание на базата данни в четим от човека формат. Инструмент, който може да се използва за тази цел е http://whois.domaintools.com/ или whoxy.com. След влизане на регламента за GDPR имената на собствениците на домейни в ЕС са маскирани и не могат да се видят, но можем да обърнем внимание на имената на сървърите, които показват компанията в която се хоства сайта. Кога е закупен домейна и до кога е платен, държавата и домейн историята.
3. DNS отпечатък. Атакуващият трябва да изброи подробностите за DNS записите и вида на сървърите. Има 10 типа DNS запис, които предоставят важна информация, свързана с целевото местоположение.
- A/AAAA
- SVR
- NS
- TXT
- MX
- CNAME
- SOA
- RP
- PTR
- HINFO
Domain Dossier е онлайн инструмент за намиране на пълен DNS отпечатък. Ако проверявате даден домейн, поставете отметката в квадратчето за DNS записи и traceroute и след това кликнете върху Go.
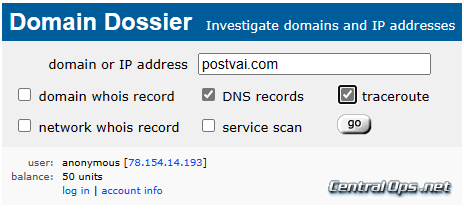
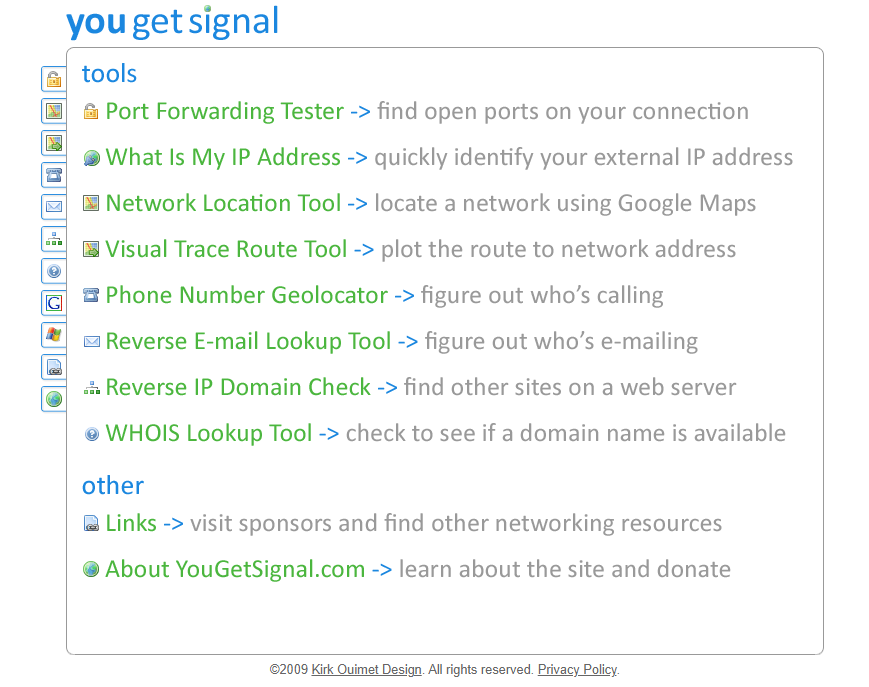
Сега може да видите всички TXT и MX записи от които да видите, каква поща ползва, има ли пренасочвания и др. Обърнете внимание на данни като google-site-verification от който може да намерите ID на собственика на сайта в Google и с инструменти , като SpyOnWeb.com да видите какви други сайтове има този човек. Има и други инструменти, като DNS Dumpster или DNSdumpster.com, който може да открие хостове, свързани с този домейн. Yougetsignal.com показва мрежовия отпечатък, отворени портове, IP адреси и други сайтове, които се хостват на същия сървър.
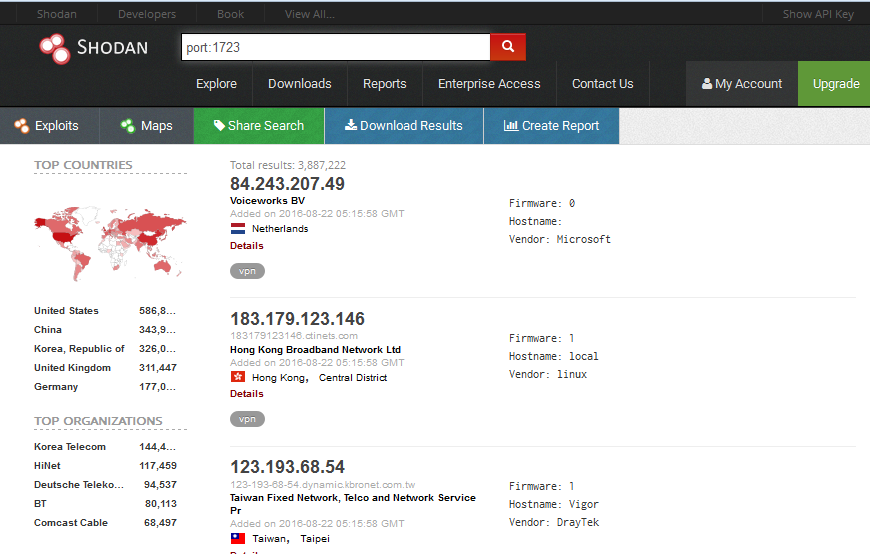
Друг начин да намерите различни отворени портове, уязвими IP адреси е да използвате търсачката на устройства в мрежата – Shodan.io. Това е вид търсачка, която за разлика от Google не търси ключови думи, а индексира мета данни, които сървърите изпращат обратно на хостинг клиенти. Това е нещо като интернет карта, която ни позволява да видим кое устройство към кое друго е свързано, кои портовете (80, 21ftp, 22 SSH, 23 telnet, 161SNMP и 5060SIP) са отворени на конкретно устройство или каква операционна система използва и т.н. В нея може да търсите: webcam, Traffic Signals, Cisco Bulgaria, Scada, netcam, GPS и други устройства.
За разузнаване на даден сайт изпишете в полето за търсене, намереното по-горе IP. Освен това можете да търсите конкретен порт. Например, на снимката по-долу е потърсен порт: 1723. Сега всички знаем, че този порт се използва за VPN, така че чрез това можем да открием кое устройство използва VPN. Може да използвате филтър за комбинация на различни параметри за да намерите търсеният от вас сайт. Когато търсите порт: 3389, той ще покаже и операционната система, използвана от устройството, което може да бъде много полезно.
4. Извличане на подробности свързани с уебсайта. В тази стъпка трябва да разберем архивното описание на сайта, системата за управление на съдържанието, скриптовете на сайта и сървъра, обхождането от ботовете, да извлечем метаданните, да направим анализ на уебстраниците на сайта.
- Започваме с инструмента Archive.org, който показва историята на всеки един уебсайт, какво е публикувал в миналото и как е изглеждал преди. Има машина за връщане на изтрито съдържание.

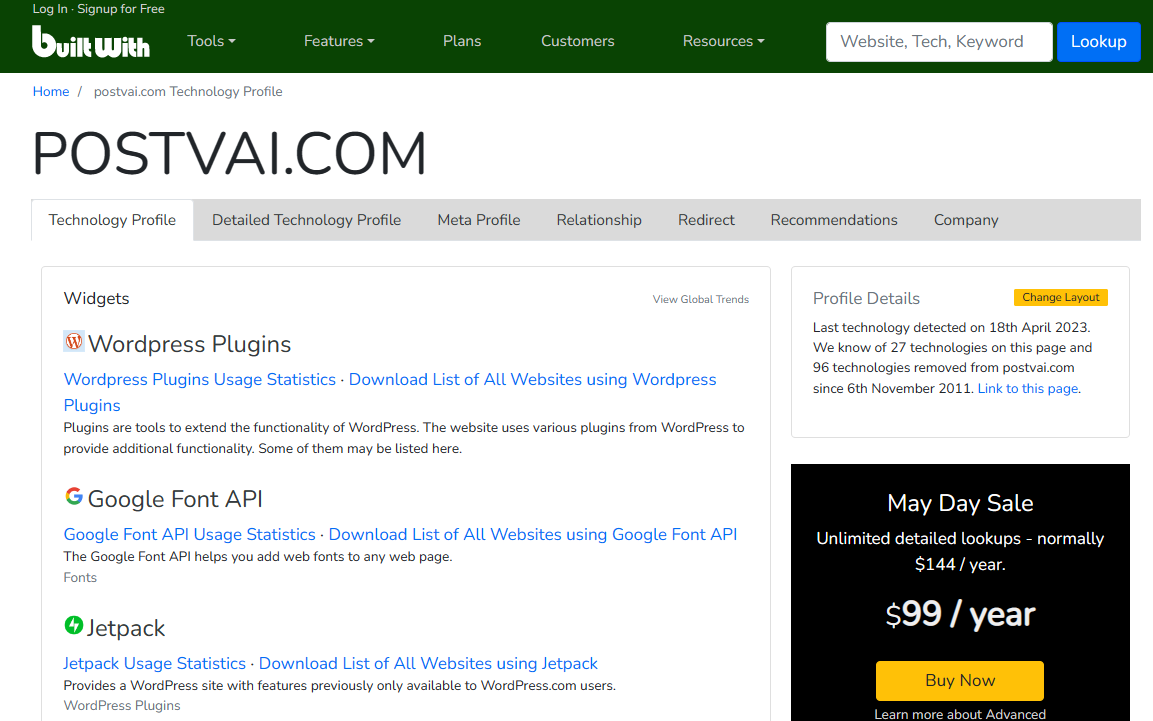
- BuiltWith.com: открива технологията с която работи уебсайта. Той показва уиджети, анализи, рамки, системи за управление на съдържанието, рекламодатели, мрежи за доставка на съдържание, уеб стандарти и уеб сървъри.
- Whatweb може да идентифицира всякакъв вид информация за уебсайт, като платформа, CMS платформа, тип скрипт, Google Analytics, платформа за уеб сървър и държава с IP адрес. Това е инструмент, който може да се използва както за разузнаване, така и като скенер за уязвимости. Отворете терминала в Kali Linux и въведете следната команда whatweb www.postvai.com. В резултат на това получаваме същата информация, както по-горе. Ако откриете, че сайта е изграден с WordPress (каквито са 50 % от сайтовете в България) използвайте този чудесен инструмент за да разберете повече WordPress Security Scan | HackerTarget.com.
- HTTrack е безплатен инструмент с отворен код, уеб робот и офлайн браузър, разработен от Ксавие Рош. Той ви позволява да изтеглите World Wide Web сайт от Интернет в локална директория, изгражда рекурсивно всички директории под формата на HTML файлове, сваля изображения и други файлове от сървъра на вашия компютър. HTTrack подрежда относителната структура на връзката в оригиналния сайт. За тази цел може да използвате и програми като Website Ripper Copier (WRC) или BlackWidow.

- Web Data Extractor Pro е специално проектиран инструмент за масово събиране и извличане на различни типове уеб данни. Той може да събира URL адреси, телефонни и факс номера, имейл адреси, както и информация за мета тагове и текст в страницата. Специална характеристика в Pro версията е за персонализираното извличане на структурирани данни. Въведете целеви URL адрес и изберете папка, за да запазите изхода и кликнете върху OK.

В резултат, този инструмент ще извлече метаданни, имейл контакт не. и т.н. от вътрешността на целевия URL адрес. Ако сте намерили имейл, може да използвате Lullar за да намерите всички сайтове в който е регистриран този имейл и да идентифицирате профила на човека зад него.
- По същия начин другият инструмент Web spider се използва като екстрактор на уеб данни:

- Website-Watcher е мощен, но прост инструмент за мониторинг на уебсайтове, напълно подходящ както за начинаещи, така и за напреднали потребители. Въвеждате целевия URL адрес, който започва да наблюдава целевия уебсайт. Има и други инструменти, които могат да наблюдават сайтове, например WebSite Watcher 2017, On web change, Follow that page, Informinder.
- Страхотен скенер за уязвимости Сканиране за уязвимости, автоматизирано за всеки бизнес (hostedscan.com) или още по-добре проверете с Penetration testing toolkit, ready to use | Pentest-Tools.com.
- Накрая след като сте събрали всичко, което може да намерите, остава да включите известия за нови промени в сайта, чрез инструменти като Visualping: #1 Website change detection, monitoring and alerts
Повече може да видите в източниците: