Урок 3 от 25
Невронни мрежи и машинно обучение
3.1. От символен към статистически изкуствен интелект
Въпреки изключителния обществен и медиен шум, генериран от неотдавнашното обявяване на сложни генеративни AI модели, е необходимо да се подчертае, че тази технология не е внезапно откритие, а продукт на десетилетия последователно научно развитие (Димитров & Никовски, 1999). За да се разбере как работи съвременният изкуствен интелект, е необходимо първо да се анализира йерархията между изкуствения интелект, машинното обучение и дълбокото обучение, като се изяснят математическите принципи, позволяващи на машините да се „учат“ от данни.
В научната литература изкуственият интелект се дефинира като широкообхватна научна област и инженерна дисциплина, изследваща методологиите за създаване на машини и софтуерни агенти, способни да демонстрират интелигентно поведение (Димитров &Никовски, 1999). AI включва теории, алгоритми, методологии и стратегически цели, обхващащи области като машинно обучение, компютърно зрение, обработка на естествен език (NLP), роботика и автоматизирано планиране. В рамките на тази дисциплина съществува строго дефинирана йерархия – машинното обучение се разглежда като поддисциплина на изкуствения интелект, дълбокото обучение е специализиран дял от машинното обучение, използващ многослойни невронни мрежи, а генеративният AI представлява специфичен клас модели в рамките на дълбокото обучение.

В контекста на отбраната е от критично значение да се направи разграничение между научната област „Изкуствен интелект“ и нейната конкретна реализация – интелектната система. Докато AI е дисциплината, интелектната система е конкретното приложение или машина, която може да възприема своята среда, да разсъждава върху събраната информация и да действа автономно или полуавтономно, за да постигне определена военна или стратегическа цел. Основната разлика между интелектната система и традиционния софтуер се състои в това, че тя не следва просто статични, предварително кодирани инструкции. Вместо това тя демонстрира динамично поведение, включващо учене, адаптация към променящите се условия на бойното поле и способност за разрешаване на неструктурирани проблеми.
Архитектурата на една интелигентна система се определя от синергията между нейните компоненти, превръщащи суровите данни в оперативно превъзходство. Основните елементи са:
- Сензорна периферия (P – Perception) – осъществява връзката с физическия свят. Във военен контекст това са радари, камери и средства за радиоелектронно разузнаване. Те дефинират вектора на наблюдение и осигуряват потока от данни в реално време.
- База знания/база данни (K) – съхранява фактическата информация и научените модели. Тя служи като цифрова когнитивна памет на системата.
- Механизъм за извод и разсъждения, като логически мотор (L) – изпълнява процеса на разсъждение, използвайки базата знания и текущите данни от сензорите. Използва логически правила или вероятностни модели (например байесови мрежи) за оценка на ситуацията.
- Модул за обучение и адаптация (Е) – сърцето на машинното обучение, което позволява на системата да подобрява своите алгоритми на базата на натрупания опит и обратната връзка от околната среда.
- Изпълнителни механизми – актьори (А) или устройства, чрез които системата взаимодейства със средата – от управление на полета на дрон до задействане на системи за киберзащита.
- Потребителски интерфейс (U) – осигурява комуникацията между човешкия оператор и AI системата, позволявайки „човек в контура“ (human-in-the-loop) при вземането на критични решения. Много често това е комуникационен модул, приемащ информация чрез разпознаване на реч и разбиране на текст или изображения.
За да представим взаимодействието между тези елементи като единна функция на системната архитектура S, можем да използваме следната формула:
S = E . L(P, K) ⊗ (A + U),
където L(P, K) е логическата функция на разсъждение, която съпоставя входящите данни от перцепцията с базата знания;
E – коефициент на обучение и адаптивност, който мащабира ефективността на логическите изводи;
⊗– оператор за координация между автоматизираното действие и човешкия контрол;
(A + U) – синергията между автономното изпълнение и намесата на оператора.
Оптимизацията на тези шест компонента води до повишаване на ситуационната осведоменост. В борбата с дезинформацията, например, сензорите са алгоритми за обработка на естествен език (NLP), които идентифицират семантични аномалии в информационното пространство, а базата знания съдържа патерни на известни хибридни заплахи. В контекста на националната сигурност и военното дело, тази структура осигурява затварянето на НОРД цикъла (Наблюдение, Ориентация, Разсъждение, Действие) и веригата на унищожаване (Kill Chain) с висока степен на автоматизация.
3.1.1. Ролята на формалната логика за представяне на знанието
Представянето на знания е концептуалният мост, който свързва суровите данни с интелигентното разсъждение. Още от древността човечеството се опитва да формализира процесите на логическо мислене, но в контекста на изкуствения интелект се оформят два основни методологични подхода – символни методи и методи, базирани на статистически данни (Goodfellow, Bengio & Courville, 2016).
Системите с изкуствен интелект се класифицират в два основни вида, които определят начина на представяне на знания и вземане на решения:
- Класически или символен AI е доминираща концепция в научните изследвания от 50-те до 80-те години на XX век. Системите тук са базирани на формална логика и правила. Интелектът се симулира чрез манипулация на символи, които представят обекти и понятия от реалния свят. Тези системи са детерминистични и лесно интерпретируеми, но страдат от трудности при обработката на несигурност и шум в данните (Димитров, Никовски, 1999).
- Модерен или статистически AI са група системи, основани на архитектури, които се обучават директно от данни, като централно място заемат изкуствените невронни мрежи. Те набраха скорост от 90-те години на ХХ в. насам и станаха доминиращи през последното десетилетие благодарение на възхода на „дълбокото обучение“. Статистическият AI е изключително мощен за откриване на сложни, скрити модели и аномалии в огромни обеми от неструктурирани данни, което го прави незаменим за съвременните отбранителни приложения, включително разузнаване, наблюдение и целеуказване.
Символните методи представят знанието експлицитно – ясно записано, като символи, логически твърдения и правила. Машината манипулира тези символи според строги правила, за да симулира интелигентност. Този подход е в основата на експертните системи, логическото програмиране и автоматичното планиране (Димитров & Никовски, 1999). Типични структури в тази категория са:
- логическото представяне на информация може да бъде ясно, логично и недвусмислено от типа „Том е една котка“
- факти и правила — основата на продукционните системи („Ако А, тогава Б“)
- семантични мрежи – знанието се представя визуално като граф, където възлите са обекти или концепции, а ребрата – релациите между тях. Семантичното представяне е за взаимовръзките между фактите: Том – котка – бозайник
- фреймове – информацията се представя в елементарни таблици, съдържащи „слотове“ за специфична информация. Например: име – Том, вид – котка, група – бозайници
- онтологии — формални и споделени спецификации на дадена област, дефиниращи йерархията от класове, свойства и ограничения.
Методите, базирани на данни и статистика, съхраняват знанието имплицитно. В този случай то не се кодира ръчно от експерти, а AI системата го извлича чрез анализ на огромни обеми от данни, съхранявайки го като числени параметри – тегла в невронни мрежи или вектори на вграждания (Goodfellow, Bengio & Courville, 2016).
Съвременните информационни системи в Индустрия 4.0 се управляват виртуално от цифрови близнаци на реални физически обекти чрез постоянен поток от данни от сензори, което често съхранява и историческия профил на обекта. Цифровият близнак дава възможност на оператора да извлече полезни данни за функционирането му и да изпробва различни сценарии. Основните предимства включват намаляване на разходите за поддръжка и престой на устройствата, оптимизиране на времето на процеса и съкращаване на времето за навлизане на нови продукти на пазара. Същевременно те имат относително висока цена на разработка, тъй като изискват фундаментални AI модели на базата на законите на физиката, химията, икономиката и т.н.
Разработването на сложни цифрови близнаци е изключително трудно и скъпо, а внедряването им в реално време изисква значителна изчислителна мощ. Алтернативното решение са емпиричните емулатори – модели, основани и задвижвани от данни, които частично заменят фундаменталните принципи. Докато цифровият двойник използва сложни диференциални уравнения и изисква висококвалифицирани специалисти, емпиричните емулатори се базират на статистика и методи на изкуствения интелект (невронни мрежи, генетично програмиране) за оптимизация, класификация и предсказване.
Целта и в двата случая е максимално точно и евтино да се моделира физическото устройство. Така се създава интелектен агент – система, притежаваща способност за:
- извличане, представяне, натрупване, коригиране, интерпретиране и обобщаване на знания чрез активно взаимодействие със средата
- използване на знания за водене на целенасочено поведение.

Чрез наблюдаване на екземпляри от поведението на агента наблюдателят създава класификационен „какво“ модел. Символното ниво осигурява средства за „механизиране“ на наблюдаваното поведение. Нивото на знания добавя поглед на целеустременост в поведението, изграждайки модел в термините на знания за средата, целите и потенциалните средства (действия) на агента.
За интелигентните системи е характерен преходът от схемата: данни + алгоритъм към схемата: знания + разсъждения. Данните са относително динамичната част от информацията – конкретни сведения за обектите в даден момент. Знанията са по-общата, относително постоянна и по-неизменяема част, валидни за цели класове обекти.
Знанието най-общо означава това, което човек е научил и разбрал за света около себе си. То представлява подредена система от твърдения, основани на реални факти. Ако погледнем знанието от лична гледна точка, то може да изглежда като мнение или убеждение, което човек има, защото вярва, че е истина, като се базира на това, което е наблюдавал. В изкуствения интелект знанието се разглежда по-тясно – тоест, интересува ни как знанието може да помогне за решаването на конкретни задачи в дадена област. Когато говорим за знание в ИИ, имаме предвид събраната и подредена информация с факти, която помага на системата да взема решения или да решава проблеми.

Предметната област на изследване е всяка област от живота, която изучаваме и ни дава информация. Например, всяко понятие – като „котка“, „дърво“ или „училище“ – определя група от обекти, споделящи общи черти. Всички неща, попадащи в тази група, образуват нейния обем. Така например, категорията „животно“ включва всички видове животни, а „котка“ – само котките. Съдържанието на едно понятие показва какви важни връзки и свойства имат обектите в тази група. Когато определим тези връзки с думи или символи, можем да проверим дали са верни или не. Такава проверена информация се счита за знание в изкуствения интелект.
Информацията е интересна, когато има смисъл и може да се използва за решаване на проблеми. Например, ако знаем формулата за лицето на квадрат, това ни помага да изчислим площта на всякакъв квадрат – това е знание. Ако знаем само дължината на една страна на конкретен квадрат, това са данни. Знанието е по-общо и по-трайно, докато данните са по-конкретни и временни. Стойностите на признаците, които получаваме от наблюдения или измервания (например дължина, температура, цвят), се наричат данни. Те описват обектите в даден момент. Знанието, от друга страна, показва по-общи закономерности, които важат за повече обекти или случаи.
Предположение е всяко изказване, което може да бъде записано в езика за представяне и подлежащо на обосновка. Хипотезата е обосновано предположение (за което не е доказано че е истинно, но в достатъчна степен се смята, че може да е такова). Знанието е обосновано истинно предположение доказано с факти или правила. Фактите носят истинска информация, а правилата – при определени условия. Базата знания е съвкупност от истинни предположения, записани в езика на представяне.

Знанието може да се представя и използва по различни начини. Например, има декларативни знания – това са факти и правила, които са записани и могат да се проверят независимо от начина, по който ще се използват – „Всеки квадрат има четири страни“. Ако знаем също, че „фигура А е квадрат“, можем да заключим, че „фигура А има четири страни“.
Процедурните знания, от друга страна, са инструкции как да направим нещо – например, стъпките за намиране на площта на квадрат. Те са като рецепта, която трябва да следваме, за да постигнем определен резултат. Тези знания са нужни, за да изпълним задача правилно. Основни модели за представяне на знания в изкуствения интелект са: логически модели, които боравят с понятията „истина“ и „лъжа“, но се използват и мрежови, фреймови и продукционни модели.
Механизмите за разсъждение могат да бъдат:
- дедуктивен извод – от общи правила и конкретни факти се извеждат конкретни заключения. Пример: ако е известно, че „всяко кубче има отвор“ и че „обектът O е кубче“, то може да се заключи, че „обектът O има отвор“
- индуктивен извод – от конкретни примери се извеждат общи правила
- абдуктивен извод – формиране на най-доброто обяснение за наблюдавани факти.
3.1.2. Съждително, предикатно смятане и размита логика
Формалната логика е двигателят на всяка интелигентна система. В науката за AI се разграничават три основни нива на логическа сложност (Димитров & Никовски, 1999):
- Съждително смятане – най-простият формален език, работещ с прости твърдения, които могат да бъдат само истинни (1) или неистинни (0). Използва логически оператори като И (AND), ИЛИ (OR) и НЕ (NOT). Основното му ограничение е невъзможността да работи с променливи или да изразява вътрешната структура на обектите.
- Предикатно смятане – разширява съждителното смятане чрез въвеждането на обекти, предикати, променливи и квантори. Това позволява моделиране на сложни знания за света, като йерархии и отношения между обекти (напр. „Всички дронове от клас X имат сензор Y“). Тази логика е в основата на езика Prolog и експертните системи за планиране (Димитров &Никовски, 1999).
- Размита логика – концепция, предложена от Лотфи Заде през 1965 г., която адресира несигурността и неточността на реалния свят (Zadeh 1965). Вместо бинарните стойности 0 и 1, размитата логика използва степени на истинност. Това е критично за отбранителните системи, работещи с понятия без строги граници като „висока температура“, „бърза скорост“ или „значителен риск“.
Съждителното смятане е формална система, която превръща човешките разсъждения в математически модели. В неговия център стои елементарното съждение – твърдение, изречение на естествен език, което притежава точно една от две възможни стойности: истина (1) или лъжа (0). То не може да бъде и двете едновременно, нито пък въпрос или заповед.
- Пример за съждение А: „Слънцето е звезда.“ (Това е истина).
- Пример за съждение B: „2 + 2 = 5.“ (Това е лъжа).
- НЕ е съждение: „Колко е часът?“ или „Затвори вратата!“.
От формална гледна точка елементарно съждение е двойката <знак, стойност>. Сложните мисли се изграждат чрез свързване на прости съждения (променливи като А, B, P, Q, R) с помощта на логически връзки. От елементарните съждения могат да се образуват съставни чрез преобразуване посредством частицата „не“, както и чрез съчетаване с помощта на съюзите (наричани съждителни връзки) „и“, „или“, „ако… то…“, „тогава и само тогава“, „ако и само ако“. Истинностната стойност на всяко съставно съждение се определя в зависимост от истинностните стойности на участващите в него елементарни съждения. Ето как те определят истинността на цялото изречение:
| Операция | Символ | Смисъл | Кога е Истина? |
|---|---|---|---|
| Отрицание | ¬ | „не“ | Когато оригиналът е лъжа |
| Конюнкция | ∧ | „и“ | Само ако всички части са истина |
| Дизюнкция | ∨ | „или“ | Ако поне една част е истина |
| Импликация | → | „ако… то…“ | Винаги, освен при комбинацията (истина → лъжа) |
| Еквивалентност | ↔ | „само ако“ | Когато и двете страни са еднакви (И – И или Л – Л) |
Ако имаме две прости съждения: A: „Навън вали“ и B: „Аз нося чадър.“, можем да ги свързваме, точно както в езика използваме съюзи. Тези връзки се наричат логически оператори. Най-лесният оператор е отрицанието не (¬). Той просто обръща стойността на съждението. Например, ако A е „Истина“, то ¬ A е „Лъжа“.
Еквивалентни формули се обозначават с ∧ за конюнкция (логическо „и“), ∨ за дизюнкция (логическо „или“), ¬ за отрицание, → за импликация, ↔ за еквивалентност. Основни логически закони са:
- идемпотентност: x ∨ x = x; x ∧ x = x
- комутативност: x ∨ y = y ∨ x; x ∧ y = y ∧ x
- асоциативност: (x ∨ y) ∨ z = x ∨ (y ∨ z); (x ∧ y) ∧ z = x ∧ (y ∧ z)
- дистрибутивност: x ∧ (y ∨ z) = (x ∧ y) ∨ (x ∧ z); x ∨ (y ∧ z) = (x ∨ y) ∧ (x ∨ z)
- Закони на Де Морган: ¬(x ∧ y) = ¬x ∨ ¬y; ¬(x ∨ y) = ¬x ∧ ¬y
- двойно отрицание: ¬¬x = x
- Закон за изключеното трето: x ∨ ¬x = истина (тавтология)
- Закон за противоречието: x ∧ ¬x = лъжа (контрадикция).
За да разберем едно сложно съждение, обикновено се използва истинна таблица, която показва всички възможни комбинации. Например, ако вземем две прости съждения: P: „Слънцето грее.“ Q: „Отивам на плаж.“, а ние разглеждаме формулата: P∧¬Q, която се чете: „Слънцето грее И не отивам на плаж“, ето как изглежда таблицата за истинност в тази ситуация:
| P (Слънце) | Q (Плаж) | ¬Q (Не на плаж) | P∧¬Q (Резултат) |
|---|---|---|---|
| И (Истина) | И (Истина) | Л (Лъжа) | Л (Лъжа) |
| И (Истина) | Л (Лъжа) | И (Истина) | И (Истина) |
| Л (Лъжа) | И (Истина) | Л (Лъжа) | Л (Лъжа) |
| Л (Лъжа) | Л (Лъжа) | И (Истина) | Л (Лъжа) |
Обърнете внимание на втория ред, където резултатът е Истина. Това е единственият сценарий, при който цялото твърдение е вярно: когато слънцето наистина грее, но човека по някаква причина не е на плажа.
Въпрос за размисъл. Ако променим формулата на P → Q („Ако слънцето грее, то отивам на плаж“), при коя комбинация от таблицата твърдението ще бъде Лъжа? (Погледнете частта за импликация, ако имате нужда от жокер).
Предикатното смятане е фундаментален раздел от математическата логика, въведен от германския математик Готлоб Фреге. То играе ключова роля в развитието на изкуствения интелект, тъй като предоставя мощен формален апарат за описание и анализ на знания в различни предметни области (Димитров & Никовски, 1999). Предикатното смятане е следващото ниво в логиката след съждителното смятане. Ако съждителното смятане разглежда целите изречения като „черни кутии“ (истина или лъжа), предикатното смятане „влиза“ вътре в изречението, за да разбере връзките между обектите и техните свойства.
Ако в съждителното смятане казваме: P: „Иван е човек“ и Q: „Мария е човек“, то в предикатното смятане използваме предикати – това са функции, които описват свойство или връзка. Нека H(x) означава „x е човек“. Тогава: H(Иван) е истина, H(Мария) е истина. Тук H е предикатът (свойството), а Иван е обектът.
Предикатите могат да се разглеждат като съждения, които съдържат променливи. Всяка променлива може да приема стойности от определена предметна област, а истинността на съждението зависи от конкретните стойности, които тези променливи получават. Така предикатите позволяват да се формулират общи твърдения за обекти и техните свойства или отношения.
Също така се използват квантори – за „всички“ и за „някои“. Именно това е „суперсилата“ на предикатното смятане. То ни позволява да говорим за групи от обекти, използвайки два специални символа – универсален квантор (∀), който означава „за всеки“ или „всички“ и екзистенциален квантор (∃), който означава „съществува поне един“.
- ∀x H(x) означава „Всички обекти са хора“
- ∃x H(x) означава „Съществува поне един обект, който е човек“.
Синтаксисът на предикатното смятане се основава на ясно определен набор от символи и правила за построяване на валидни изрази. Азбуката на предикатното смятане включва:
- константи – имена на конкретни обекти (обикновено малки латински букви или цифри)
- променливи – означават произволни обекти (главни латински букви)
- функции – имена на функционални зависимости с определена арност (брой аргументи)
- предикати – имена на релационни свойства с определена арност
- логически символи – за съждителни връзки (∧, ∨, ¬, →, ↔), скоби
- квантори – ∀ (квантор за общност, „за всяко“) и ∃ (квантор за съществуване, „съществува поне едно“).
Например, имаме група от плодове: ябълка, банан и круша. Нека предикатът F(x) означава „x е жълт“. Ако знаем, че: ябълката е червена; бананът е жълт; крушата е зелена, кое от двете твърдения е вярно за тази група плодове ∀x F(x) (Всички плодове са жълти) или ∃x F(x) (Съществува поне един жълт плод). Кой е правилният отговор? Тъй като само бананът е жълт втората опция ∃x F(x) е истина, а първото твърдение е лъжа, защото не всички плодове в нашата група са жълти.
Докато съждителното смятане описва само свойства (като „Иван е човек“), предикатното може да описва отношения между двама или повече души. Например: L(x, y) означава „x обича y“. С това можем да изразим много различни неща, в зависимост от това как подредим кванторите:
- ∀𝑥∀𝑦𝐿(𝑥,𝑦) – всеки обича всекиго
- ∃𝑥∃𝑦 𝐿(𝑥,𝑦) – някой обича някого.
- ∀𝑥∃𝑦 𝐿(𝑥,𝑦) – всеки обича някого (всеки си има някой, когото обича).
Забележете как редът и видът на кванторите променят смисъла на изречението.
За упражнение, нека дефинираме следното: S(x) означава „x е студент“. R(x) означава „x чете книги“. Как би изглеждала на обикновен език формулата ∃x (S(x)∧R(x)) ?
Отговорът е „Съществува поне един студент, които чете книги.“ Кванторът за съществуване (∃x), който ни казва, че има „поне един“ такъв обект. Конюнкцията ( ∧), която свързва двете свойства – да бъдеш студент и да четеш книги.
Предикатното смятане ни позволява да бъдем много прецизни и дори да използваме конкретни термове – основните градивни елементи на изразите. Това са имената, с които назоваваме обектите. Всеки термин представлява обект от предметната област и може да бъде константа (конкретни имена – Иван, Мария), променлива (x, y, z, които могат да бъдат всеки обект) или резултат от прилагане на функция върху други термове. Например, ако имаме функцията баща(x), то баща(Иван) е терм, който сочи към конкретен човек (бащата на Иван).
- Човек(Иван) – предикат с един терм (свойство)
- Брат(Иван, Петър) – предикат с два терма (връзка).
Кванторите позволяват да се изразяват обобщени твърдения. Формулите от вида (∀v α) и (∃v α) се наричат квантифицирани, като обхватът (областта на действие) на квантора е формулата, към която е приложен. Променливата се нарича „свързана“ във формулата, ако се намира в обхвата на квантор, в противен случай е „свободна“. Формула без свободни променливи се нарича „затворена“.
- свободна – в израза „Обича(x, сладолед)“ променливата x е свободна. Не знаем кой е x, той е просто „празно място“
- свързана: В израза ∀x Обича(x, сладолед), променливата x вече е „свързана“ от квантора ∀ (всеки). Сега вече знаем за кого говорим – за всички.
Светът, в който работи предикатното смятане, се нарича „предметна област“. Тя включва всички обекти, техните свойства и връзките помежду им, които са важни за решаването на проблема. Ако решаваме логическа задача за шах, предметната област обхваща шахматната дъска, нейните 64 квадрата и всички фигури. В този контекст фигурите и квадратите са нашите обекти. Всичко извън тази област (например времето навън или цветът на масата) е несъществено и се изключва от логическия анализ.
Обект е всяко отделно нещо, което можем да различим. Това може да е реален предмет (като фигура на кон) или абстрактна идея (като числото 5). За да бъде нещо обект, то трябва да е ясно дефинирано и различно от останалите.
Предметът е обект, върху който сме фокусирали вниманието си в конкретния момент. Когато анализираме свойствата на един обект (например „Конят е бял“), той се превръща в наш предмет на изследване. Предметът е обект, който е подложен на изследване, анализ или наблюдение, като се разглежда с оглед на определени свойства и взаимоотношения. Предметът има свойства и връзки, но при абстракция на реалността, при която се игнорират несъществени характеристики. Така „предметна област“ фиксира гледната точка, от която се извършва анализът, и определя кои свойства и връзки между обектите са значими за конкретната задача.
Както отбелязва Нилс Нилсон: „Всеки език за представяне на знания в интелектните системи трябва да бъде най-малкото толкова изразителен, колкото предикатното смятане от първи ред“ (Nilsson 1980). Това подчертава значението на предикатното смятане като минимален стандарт за формализиране на знанието.
Размитата логика е класическа логика в която всичко е черно или бяло (0 или 1). Например: „Един човек е или висок, или не е“. Но в реалния живот, ако някой е висок 179 см, той висок ли е? А този, който е 181 см? Размитата логика казва: „Този човек е 80% висок“. Тя работи със степени на истина (числа между 0 и 1).
Ако трябва да изградим интелигентна система за управление на дрон, която трябва да реши колко силно да надуе двигателите според вятъра, размитатата логика постановява изграждането в три стъпки:
- Фазификация (Размиване) –дронът измерва скорост на вятъра точно 45 км/ч. Системата превръща това число в понятия – „Вятърът е 30% СИЛЕН и 70% УМЕРЕН“.
- Оценка на правилата – системата гледа своята база от знания: „АКО вятърът е СИЛЕН, ТОГАВА увеличи мощността ЗНАЧИТЕЛНО“. Тук се пресмята как точно се комбинират тези „размити“ условия.
- Дефазификация (Изчистване) – накрая дронът не може да изпълни команда „малко мощност“. Той се нуждае от число. Дефазификацията превръща размития резултат в конкретна стойност, например „Подай 12,5 волта към мотора“.
3.1.3. Семантични мрежи и онтологии
структуриране и представяне на знания
Докато логическите изчисления (съждително, предикатно смятане) ни дават правилата за извеждане на заключения, семантичните мрежи предоставят графичния модел за това как различните обекти, концепции и техните релации се съхраняват в паметта на една интелигентна система. Семантичната мрежа е модел за представяне на знания, който използва структурата на насочен граф:
- Възлите (Nodes) представляват конкретни военни обекти (екземпляри) или абстрактни концепции (класове). В една военна база данни възли могат да бъдат „Т-72“, „1-ва бронетанкова бригада“ или „дизелово гориво“.
- Дъгите/ръбовете представляват релациите между тях (напр. „Е вид“, „Притежава“, „Намира се в“, „Е съюзник на“).

Едно от най-мощните свойства на семантичните мрежи е автоматичното извеждане на нови знания чрез транзитивни релации. Ако знаем, че „Т-72“ е вид „Основен боен танк“ и „Основният боен танк“ има „броня“, системата автоматично извежда заключението, че „Т-72“ има броня, дори това да не е изрично записано за конкретния модел.
В съвременните военни доктрини (като мрежовоцентрични войни), семантичните мрежи са критични за ситуационната осведоменост и създаване на единна картина на бойното поле, където сензори, платформи и човешки ресурси са свързани чрез семантични релации (кой обект е заплаха, кой е неутрален и каква е връзката между тях). Семантичните мрежи могат да се използват при управление на веригата за доставки и автоматизирано проследяване на ресурси, например – „Склад А“ съдържа „Резервни части“, които са необходими за „Вертолет Б“. Също така се употребяват в платформите за подпомагане вземането на решения (C2 – Command and Control), които използват онтологии (разширени семантични мрежи), за да разпознаят сложни тактически модели.
В дигиталните умения за отбрана често се преминава от прости мрежи към военни онтологии. Въпреки че често се използват взаимнозаменяемо в по-общ контекст, в инженерството на знанията съществува ясна разграничителна линия между двете концепции. Докато семантичната мрежа се фокусира върху структурата на данните и асоциативните връзки, то онтологията е формално описание на знанието в конкретна област (напр. „Градски бой“ или „Киберсигурност“). Обикновено тя включва:
- Таксономия – йерархия на обектите (напр. противовъздушна отбрана (ПВО) -> С-400).
- Аксиоми – правила, които винаги са верни (напр. „Никоя единица не може да бъде едновременно в движение и в ремонт“).
| Характеристика | Семантична мрежа | Онтология |
|---|---|---|
| Основна цел | Представяне на релации между обекти | Дефиниране на структура и логически правила |
| Ниво на формализъм | По-ниско (асоциативно) | Високо (математическа логика) |
| Компоненти | Възли и дъги | Класове, свойства, аксиоми, инстанции |
| Приложение | Търсене на пътища, асоциации | Разсъждаване (Reasoning), оперативна съвместимост |
Да разгледаме следния пример за радарното засичане:
- Сензорно ниво – радарът подава сурови данни: обект O1, скорост v=2.5 “Mach”.
- Онтологично ниво – системата проверява дефинираните категории. В онтологията за „Въздушни заплахи“ съществува правило:
“If” v>“Mach”2.0⟹“Category: Ballistic/High-Speed Threat”.
- Семантично ниво – в мрежата се активира възелът „Заплаха“. Чрез релацията „Намира се в“ системата веднага идентифицира кои приятелски единици са в обсега на траекторията на O1.
Този подход е в основата на борбата с дезинформацията и хибридните заплахи, тъй като позволява на алгоритмите да откриват логически противоречия в постъпващата информация чрез съпоставяне с установени онтологични аксиоми. Предимствата на тези мрежи са, че човекът оператор може лесно да разбере защо машината е взела дадено решение и позволява бързо търсене в сложни структури от данни. Недостатъците са, че при разрастване на мрежата става трудно да се избягват логически противоречия и трудно се справят с несигурност или вероятностни събития (тук се налага намесата на размитата логика или статистиката).
Въпреки своята прецизност, семантичните мрежи изискват ръчно дефиниране на всяка връзка от експерти. В динамичната среда на модерната отбрана, където данните са огромни и неструктурирани, този „ръчен“ подход става недостатъчен. Това налага прехода към статистически модели и машинно обучение, където машината сама открива зависимостите в данните, вместо да разчита на предварително начертани карти на знанието.
3.1.4. Преходът към статистически модели
и анализ на големи масиви от данни
Преходът от символен към статистически AI е обусловен от няколко фундаментални ограничения на класическите подходи. Символните системи изискват ръчно кодиране на знанията от експерти, което е трудоемък и скъп процес, наречен „бутилково гърло на знанието“. Те са чувствителни към шум в данните и не могат ефективно да се справят с неструктурирана информация като изображения, звук и естествен език.
Статистиката и машинното обучение предлагат алтернатива – вместо да се програмират правила, системите се обучават от примери. С нарастването на изчислителната мощ и наличността на големи масиви от данни (Big Data) статистическите методи демонстрират превъзходна производителност в задачи като разпознаване на образи, обработка на естествен език и предсказателен анализ. Това доведе до доминирането на подходите, базирани на данни, в съвременния AI (Goodfellow, Bengio & Courville, 2016).

3.2. Класически методи на машинно обучение
Машинното обучение (Machine Learning) представлява междудисциплинарна област на изследване, която се занимава с разработването на алгоритми, позволяващи на компютърните системи да подобряват производителността си при изпълнение на специфични задачи чрез натрупване на опит от данни, без да бъдат изрично програмирани за всяка конкретна ситуация (Samuel 1959; Mitchell 1997). Според формалната дефиниция на Том Мичъл, компютърна програма се счита, че учи от опит E по отношение на клас задачи T и мярка за производителност P, ако нейната производителност при задачите в T, измерена с P, се подобрява с опита E (Mitchell 1997).
Основната парадигма на машинното обучение изисква наличието на три фундаментални компонента (Mitchell 1997; Goodfellow, Bengio & Courville, 2016):
- модел – хипотеза или структура, която се обучава
- данни – обучителни примери, представляващи опита E
- алгоритъм за обучение – оптимизационен метод за напасване на параметрите на модела към данните.
В зависимост от начина на подаване на обратна връзка по време на тренировъчния процес, машинното обучение се систематизира в три основни вида:
- Контролирано обучение (Supervised Learning) – подход, при който алгоритъмът се обучава върху множество от етикетирани примери, състоящи се от входни данни (признаци) и съответните желани изходи (целеви стойности). Целта е изграждане на модел, способен да прогнозира верния изход за нови, непознати данни чрез минимизиране на функцията на грешката между прогнозираните и реалните стойности (Bishop 2006; Alpaydin 2010). Този подход намира основно приложение в задачите за класификация (присвояване на дискретни категории) и регресия (предсказване на непрекъснати числови стойности). В контекста на отбраната и сигурността, контролираното обучение се използва за разпознаване на вражеска техника в сателитни снимки чрез свръхточно класифициране на визуални модели (Димитров &Никовски, 1999).
- Неконтролирано обучение (Unsupervised Learning) – функционира при липса на етикетирани данни, като алгоритмите се стремят да открият скрити структури, клъстери (групи от сходни обекти) или разпределения в данните без предварителна информация за целевите категории (Alpaydin 2010). Методите на неконтролираното обучение са фундаментални за откриване на аномално поведение в мрежовия трафик (киберсигурност), идентифициране на нови видове заплахи, за които липсват предварително дефинирани правила, както и за сегментация на клиенти и намаляване на размерността на данните (Bishop 2006).
- Обучение с подсилване (Reinforcement Learning) – изчислителен подход, при който агент се учи да взема решения при спазване на последователност чрез взаимодействие с динамична среда, получавайки числени сигнали за награда или наказание като обратна връзка (Sutton & Barto 2018). За разлика от контролираното обучение, където се предоставят готови примери с правилни отговори, агентът сам открива оптималната стратегия (политика) чрез метода на пробата и грешката, целейки максимизиране на кумулативната награда в дългосрочен план. Фундаменталните елементи включват агент (вземащ решения), среда (реагираща на действия), състояние (текуща ситуация), действие (изборът на агента), награда (обратна връзка от средата), политика (стратегията на поведение) и функция на стойността (оценка на дългосрочната полезност на състоянията) (Sutton & Barto 2018).
Обучението с подсилване може да се класифицира в три основни подкатегории според наличието на модел на средата:
- Model-Free RL – агентът не изгражда модел на средата, а директно учи оптимална политика чрез Q-learning, Deep Q-Networks или Policy Gradient методи. В рамките на управлението на политиките се използват два алгоритъма – PPO и GRPO, които сравняват резултатите и му дават награди за развитие на най-добрия от тях
- Model-Based RL — агентът изгражда модел на преходите между състоянията и използва планиране, както при Dyna-Q и MuZero
- Inverse Reinforcement Learning – агентът извлича функцията на наградата от поведението на експерти (Sutton & Barto 2018)
През периода 2024 – 2025 г. областта на обучението с подсилване претърпя революционни скокове в способностите, захранвайки модели като OpenAI o1, o3 и DeepSeek R1. Тези модели използват разширени вериги на разсъждение и търсене по време на извод, при което генеративният модел извършва вътрешно разсъждение за оптимизиране на стратегията преди финалния отговор. Моделът o3 постига бенчмарк 87,7% експертно ниво в науката според GPQA Diamond, 71,7% умения за софтуерно инженерство в SWE-bench Verified и Elo рейтинг 2727 на Codeforces, докато DeepSeek R1 демонстрира способност за самостоятелно развитие на поведения като рефлексия и самокорекция чрез чисто подсилващо обучение с оптимизация с относителни правила за групата (DeepSeek 2025).

Процесът на обучение може да се разглежда като вид „откривателска“ дейност, много подобен на основната парадигма на експерименталната наука – натрупване на експериментални данни и извеждане на закони въз основа на тези данни. Единствената разлика е, че експерименталната наука се провежда от хора, докато машинното обучение е процес, изпълняван от интелектен агент.
Във всеки процес на машинно обучение могат да се различат четири основни елемента, илюстрирани чрез примера с Галилео Галилей и закона за свободно падане:
- входна (независима) променлива – времето t;
- изходна (зависима) променлива – изминатото разстояние s;
- функционална зависимост – изведеният закон s = ½gt²;
- метод за избиране на правилната функционална зависимост – при Галилей – шанс, първоначални опити и интуиция, а при автономните системи – систематични алгоритми за откриване на решение.
В процеса на индуктивното разсъждение се различават два последователни етапа – извличане на знание от примери и използване на това знание върху нови входни данни. Способността за обобщение въз основа на примери е най-характерната особеност на системите с възможности за обучение.
От теоретична гледна точка е важно да се знае, че индуктивното разсъждение е недостоверно и няма същия статус като дедуктивното разсъждение. Изведеното знание е само една хипотеза, която добре обяснява експерименталните данни. Колкото и добро да е това обяснение, отникъде не следва, че хипотезата е вярна и важи винаги.

Уклон (bias) на една обучаваща се система е нейното предпочитание към едни или други хипотези в процеса на търсене на функционална зависимост. Уклонът представлява подреждането на предпочитанията към различните хипотези – винаги се избира възможно най-предпочитаната хипотеза, която обяснява експерименталните данни. Повечето уклони са подчинени на общ принцип, известен като бръсначът на Окам – предпочитание се дава на най-простото удовлетворително обяснение на дадено явление.
Ако се формулира целта на процеса на машинно обучение като максимизиране на някакъв критерий P, от математическа гледна точка този процес представлява оптимизация на функция върху множеството на всички възможни решения. Тази връзка между алгоритмите за машинно обучение и тези за оптимизация е много важна, защото ни позволява да използваме мощните методи за нелинейно оптимизиране.
Критерии за спиране на обучението са:
- прагова стойност – спиране при достигане на определен праг за критерия
- стагнация – спиране, когато всяка следваща стъпка не подобрява съществено критерия
- валидация – специфичен метод за машинно обучение, който осигурява способността за обобщение.
За да се избегне преобучение, се съставя отделен набор примери, наричан тестващо множество. Тези примери не се използват за определяне каква ще е следващата стъпка в търсенето на по-добро решение. Обикновено, в началото с подобряването на критерия върху обучаващото множество, се подобрява и този върху тестващото – системата се учи успешно. В определен момент обаче критерият върху тестовото множество започва да се влошава и това е сигнал за спиране на обучението.
Обучението на AI не е магия, а сложен процес на математическа оптимизация. Той включва настройка на милиони тегла (w) и отклонения (b), за да се минимизира разликата между прогнозата и реалността.

3.2.1. Дърво на решенията, класификация и регресия
Методът на дърво на решенията има за цел да преобразува наличните данни в логическа последователност от правила и действия. Алгоритъмът за създаване на такава структура е основан на идеята за постепенно разделяне на данните на непрекъснато нарастващи клонове на дървото на решенията.

Основна мярка в случая е ентропията, характеризираща степента на подреденост на дадена структура. Източникът на обучение при генериране на дървовидни структури е минимизиране на ентропията чрез максимизиране на критерий, наречен информационна печалба (Information Gain):
Information Gain = Entropy (преди) – Entropy (след)
Той определя количествено ентропията преди и след разделянето на дадено дърво на нови клонове. Алгоритъмът за обучение няма да раздели дървото и да добави клон, ако не увеличим информационната печалба. Коренът на дървото на решенията (root) съдържа основния въпрос и свързаните с него променливи. Дървото показва как решението зависи от различни стойности на променливите, които разделят данните на клонове. Процесът на разделяне дефинира съответни възли на решения.
Предимства на тези модели са, че те са лесни за разбиране от хората, може лесно да се дефинират бизнес правила и избор на променливи, но са ненадеждни при различен набор от данни. Често се прилагат при инвестиционни решения, банкови заеми, анализ на отлив на клиенти и др.
3.2.2. Опорни векторни машини
Съществува социална аналогия, която може да помогне за разбирането на понятието „опорен вектор“. Например, ако имаме две политически партии, които не променят подкрепата си лесно, а резултатът от изборите зависи от около 20% от нерешителните избиратели. Тези гласоподаватели са аналог на „социалните опорни вектори“.
В машинното самообучение опорните вектори се използват основно за класификация, тоест за разделяне на данни в различни категории (например спам срещу нормален имейл, болен срещу здрав пациент). Теорията на статистическото обучение показва, че не се нуждаем от всички данни, за да решим някои проблеми, а просто е необходимо да съпоставим някои точки. Ето как се съпоставят нещата:
- Твърдият електорат (Партия А и Партия Б) – това са точките от данни, които са дълбоко в своята категория. Те са ясно разпознаваеми и са далеч от „фронтовата линия“. За алгоритъма те не са толкова интересни, защото позицията им не влияе на това къде точно ще се прокара границата.
- Колебаещите се избиратели (Опорните вектори) – това са точките от данни, които се намират най-близо до другата категория. Те са „най-трудните“ за класифициране. Точно както в изборите, само тези точки определят крайния резултат (къде ще мине линията на разделение). Те буквално „опират“ или „поддържат“ границата. Ако се премахнат всички сигурни гласоподаватели от модела, границата няма да помръдне. Но ако бъде премахнат или преместен един колебаещ се (опорен вектор), границата ще се промени.
За да стане разбираема пълната картина, ето трите основни технически термина, обяснени просто:
- Хиперравнина (Hyperplane) – това е самата граница, която разделя данните. Ако данните са на 2D лист хартия, хиперравнината е просто една права линия. Ако са в 3D пространство, тя е двуизмерен лист (равнина). Целта на алгоритъма е да намери най-добрата хиперравнина, която разделя двете класи.
- Марж (Margin) – това е „ничията земя“ или буферната зона около хиперравнината. Целта не е просто да начертае линия между двете класи, а да начертае линията така, че тя да е максимално отдалечена от най-близките точки (опорните вектори) и на двете групи. По-голям марж означава по-сигурна и стабилна класификация при нови, непознати данни.
- Опорни вектори (Support Vectors) – както вече уточнихме, това са данните, които лежат на самия ръб на този марж. Те са скелетът на модела.
Ако си представим, че избирателите не са ясно разделени на „ляво“ и „дясно“, а са напълно смесени (например, живеят в едни и същи квартали), една права линия няма да може да ги раздели. Тук методът използва нещо, наречено „Ядрен трик“ (Kernel Trick). Алгоритъмът добавя ново измерение (например, освен по квартал, започва да ги разглежда и по доходи или възраст), „повдига“ данните в 3D пространство и изведнъж става възможно да се прокара права линия (равнина) между тях. Тази характеристика дава две уникални възможности:
- да се сравни информационното съдържание на всяка нова точка от данни със съществуващите опорни вектори и да се определи дали тя включва неизвестна информация (новост)
- да се кондензира големият брой записи на данни в малък брой опорни вектори с високо информационно съдържание – често 10 – 15% от оригиналните записи.

На практика това се прави със сложна математика, но днес има готови библиотеки в езици за програмиране като Python, най-често библиотеката scikit-learn. Ето как изглежда процесът стъпка по стъпка в реалния свят след като импортираме библиотеката:
- имаме таблица с данни (например характеристики на тумори и информация дали са доброкачествени или злокачествени)
- зареждане в модела тези данни на алгоритъма
- обучаваме алгоритъм, като той анализира данните и намира оптималната граница и опорните вектори
- даваме на алгоритъма нови, невиждани досега данни и той предсказва и ни казва в коя категория попадат.
Недостатъкът е, че има множество параметри за настройка, включително сложни математически трансформации, наречени „ядра“ (kernels). Въпреки това често се прилага в медицински приложения (откриване на левкемия, рак, анализ на мамограми), биоинформатиката (класификация на тъкани, структура на протеини), производство (косвени сензори, усъвършенстван контрол на процесите), категоризиране на текст.
3.2.3. Вериги на Марков
Веригите на Марков представляват математически модели, описващи поредица от вероятни събития, в които вероятността за всяко събитие зависи от състоянието, постигнато по време на предходното. Моделът прогнозира резултати, базирани на вероятности и наличните данни. След като бъде обучен, той трябва само да знае условията в непосредственото минало за да извлече свързана информация и да прогнозира бъдещето.
Тези вериги се основават на формализирането на динамични системи, чието бъдещо състояние зависи единствено от настоящото, но не и от поредицата събития, които са довели до него. Това е известно като Свойство на Марков. Формално за последователност от състояния S₁, S₂, …, Sₙ вероятността за преход към състояние Sₜ₊₁ се определя условно само от текущото състояние Sₜ:
P(Sₜ₊₁ | Sₜ, Sₜ₋₁, …, S₁) = P(Sₜ₊₁ | Sₜ)

Нека си представим, че имаме AI система за противовъздушна отбрана (ПВО), която решава дали да стреля по цел. Диаграмата описва логиката на софтуера, който управлява радара и ракетите:
- S1 е режим „Наблюдение“. AI следи небето и всичко е нормално, което съвпада 0,85 (85%) шанс това да е така. AI преценява, че обектите на екрана са птици или облаци и остава в режим наблюдение в състояние S1. Той остава в режим наблюдение и не хаби скъпи ракети
- При шанс 0,15 (15%) AI засича скорост и траектория, които приличат на вражеска ракета. Той взема решение да премине в Режим „Прицелване“ или състояние
- S2. Тук AI е насочил оръжията и е готов за стрелба. При 0,80 (80%) шанс системата потвърждава, че това наистина е заплаха. Тя задържа фокуса върху целта, докато чака идеалния момент за изстрел
- 0,20 (20%) шанс – AI прави допълнителен анализ и разбира, че това е „фалшива тревога“ (например пътнически самолет с грешен сигнал). Той веднага сваля готовността и се връща в Режим „Наблюдение“ (S1).
Военните инженери използват тези числа, за да настроят агресивността на изкуствения интелект:
- чувствителност (0,15) – ако увеличим това число на 0,50, AI ще бъде „параноичен“ – ще се прицелва във всичко, което лети
- скептицизъм (0,20) – това е защитата срещу грешки. Ако това число е 0,01, веднъж прицелил се, AI почти никога няма да се откаже, което може да доведе до трагични инциденти (приятелски огън).
Веригите на Марков имат широко приложение в изкуствения интелект – от прогнозиране на климатични модели и финансови пазари до системите за предлагане на текст. Съвременните смартфони използват тези модели за предвиждане на думи при въвеждане на текст – функцията, която познава думата по първите ѝ букви, се базира на вероятностни модели, обучени върху големи корпуси от езикови данни. Веригите на Марков са фундаментални за разбирането на скритите модели, които намират приложение в разпознаването на реч, обработката на естествен език и биоинформатиката.
3.2.4. Алгоритъм за обратно разпространение на грешката
Тъй като директното изчисление е невъзможно, при сложни мрежи се използва стохастично градиентно отклонение – итеративен процес, при който алгоритъмът прави малки стъпки в посока, която намалява грешката. Модерният стандарт за оптимизация е алгоритъмът Adam (Adaptive Moment Estimation), предложен от Кингма и Ба (Kingma & Ba, 2014), който адаптивно регулира скоростта на обучение за всеки параметър.
Обратното разпространение на грешката е ключовият механизъм, чрез който мрежата се учи от грешките си. Ако например обучаваме един робот-стрелец да уцелва центъра на мишена, в началото той е пълен новобранец и стреля напосоки. Обратното разпространение е начинът, по който той се учи от всеки пропуск и то минава през следните стъпки:
- Изстрелът (изчисляване на грешката). Роботът стреля, данните за насоката минават през неговата мрежа, но уцелва далеч от центъра.
- Колко много сбъркахме? (Връща грешката през слоевете). Роботът изважда една линийка и измерва разстоянието от дупката до центъра на мишената. Това разстояние е грешката (или „загубата“). Колкото по-голямо е то, толкова по-лошо се е справил.
- Кой е виновен? (Backpropagation). Роботът започва да мисли отзад напред: „Ръката ми се разтрепери в последния момент? А може би краката ми не бяха стабилни?“. Той пресмята градиента – това е просто име за въпроса колко точно виновна е всяка част от тялото ми за този лош изстрел. Ако китката е виновна на 80%, а кракът само на 5%, той знае къде трябва да направи най-голямата промяна.
- Малка поправка (корекция). Ако роботът направи огромна промяна, може да подмине центъра, затова той прави малка промяна (стохастично градиентно отклонение). Той леко стяга китката.
Този цикъл се повтаря хиляди пъти (епохи), докато мрежата достигне желаната точност. Започваме обяснението от изходния слой, където имаме стойността на грешката. След това изчисляваме тегловните коефициенти на невроните в скрития слой на мрежата. В края на обратното разпространение изчисляваме останалите тегловни коефициенти за матрицата на връзките между входния и скрития слой.
Алгоритъмът за обратно разпространение не е защитен от капана на локалните минимуми. Намереният минимум не гарантира най-ефективната структура на модела с минималната грешка, защото той не е глобален. Ако започваме процеса на обучение в различни позиции, е вероятно да достигнем до различни локални минимуми, които генерират модели с различно качество. За компенсация на този фундаментален недостатък се използват множество трикове, но най-сигурното средство е да се победи случайният характер на попадение в глобалния минимум чрез многократно пускане на алгоритъма.
3.2.5. Методи на градиентното спускане и оптимизация на теглата
Спускането по градиент е оптимизационен алгоритъм, който води към минимума. Разликата между спускането по градиент и обратното разпространение е, че обратното разпространение е процес на изчисляване на производните, докато спускането по градиент е процес на намиране на минимума. Параметрите на модела w се настройват така, че да се спускат надолу от началната си стойност по функцията на загубите – J(w). Когато достигнат оптималните си стойности, градиентът е нулев, т.е. функцията на загубите е минимална J(w).
Представете си, че сте се изгубили в планината през нощта и е паднала гъста мъгла. Трябва да слезете до хижата, която се намира в най-ниската точка на долината, но не се вижда нищо.
- Градиентно спускане: пътят надолу. Тъй като не виждаш хижата, ти използваш краката си, за да усетиш наклона на земята под теб. Твоето тегло (w) е твоята позиция в планината. Функция на загубата (J(w)) е твоята височина. Колкото си по-високо, толкова по-голяма е „загубата“ (грешката). Твоята цел е височина нула (хижата). Градиентът е наклонът. Ти правиш малка крачка в посоката, където усещаш, че е най-стръмно надолу. Обратното разпространение е просто сензорът в краката ти, който ти казва „наклонът е наляво“. Градиентното спускане е самото ходене стъпка по стъпка надолу.
- Камъните по пътя са препятствия. Има локален минимум, малка дупка на склона. Ако слезеш в нея, усещаш, че накъдето и да тръгнеш е „нагоре“, и решаваш, че си стигнал хижата. Но тя всъщност е още много по-надолу. Заклещваш се там, защото краката ти не усещат наклон и си мислиш: „Тук ще си остана“. В допълнение към капана на локалния минимум може да има и други препятствия – например седлова точка или изчезващ градиент, който е голяма, идеално плоска поляна. Краката ти не усещат никакъв наклон. Не знаеш накъде да тръгнеш и спираш да се учиш (да вървиш).
- Трансферното обучение на голям AI модел е като да строиш магистрала през цялата планина – отнема седмици и струва милиони. Ако ти трябва просто пътечка до твоето село (Модел Б), няма нужда да строиш всичко от нулата. Вземаш Модел А (голям модел, който вече знае как изглеждат планините, дърветата и камъните). Просто „дорисуваш“ последните 100 метра до твоята врата. Това е Transfer Learning. Пести време, пари и компютърна мощ (Рикардс, 2025)
Важно е да се отбележи, че процесът на обучение в мозъка не се основава на принципите на обратното разпространение. Хората не се обучават на базата на изчисляване на производни. Мозъкът не е калкулатор. Когато се учите да карате колело, не изчислявате „производни“ и „градиенти“ в главата си. Не смятате сложни математически уравнения, за да разберете колко точно да натиснете спирачката. Мозъкът учи чрез опит, биологични сигнали и асоциации, които са много по-сложни и различни от математическото „спускане по наклон“, което ползва AI.
Градиентното спускане се използва за намиране на най-ефективното състояние на модела, при което той прави най-малко грешки (минимална функция на загубите). Трансферното обучение спестява ресурси и позволява използването на огромни модели (като GPT) за специфични, малки задачи без нужда от суперкомпютри. Прилага се, когато нямаме достатъчно примери (напр. за разпознаване на снимки на рядка болест), като се използва „базовото знание“ на модел, обучен на милиони общи изображения.
3.3. Математически модел на изкуствен неврон
и архитектура на перцептрон
Невронните мрежи са първата технология в историята на изкуствения интелект. Първата публикация, свързана с тази област, е от 1943 г. за „електронния мозък“. Това е първият опит да се имитира клетка на мозъка – невронът (McCulloch & Pitts 1943).
Невронът има клетъчно тяло с ядро, входове от синапси/дендрити и изходи от аксони. Невронът се задейства от електрически импулси в посока от ляво надясно. Той реагира на входните сигнали чрез силата на връзката на синапсите. В обратния случай синаптичната връзка отслабва, а под някаква долна граница дори изчезва. През 1943 г. Уорън Маккълок (1898 –1969) и математикът Уолтър Питс (1923 – 1969) демонстрират, че мрежа от елементи, наподобяващи човешките нервни клетки, по които протичат електрически сигнали, може да имитира машината на Тюринг (McCulloch & Pitts 1943). Те допускат, че мозъкът може би е вид жив компютър, което означава, че един „електрически мозък“ може да изпълнява същите програми като човешкия. Тази теория е известна под името „множествена реализируемост“.
Маккълок и Питс си дават сметка, че невроните могат да функционират като логически портали — устройства, които могат да се включват и изключват в зависимост от входящите данни. Учените описват въображаем неврон, който наричат гранична логическа единица. Този неврон работи, като първо добавя стойност към входящите си данни (сигналите от другите неврони), след което умножава тази стойност по променлива, наречена тегло, която изразява силата на връзката между невроните. Ако входящите сигнали надхвърлят определена стойност (праг), невронът се активира и изпраща изходящ сигнал. Това активиране се нарича активираща функция.
Биологичната структура е представена с прост математически модел като съвкупност от входове, представляващи синапси и дендрити, клетъчно тяло, изразено като сумиращо устройство, и аксони, отразяващи изходите. Моделът на Маккълок-Питс е силно опростена биологична аналогия, която работи с бинарни сигнали. Той се състои от следните компоненти:
- входове (xᵢ) – набор от бинарни сигнали x₁, x₂, …, xₙ, където xᵢ ∈ {0,1}
- тегла (wᵢ) – в оригиналния модел теглата са фиксирани (възбуждащи +1 или задържащи/инхибиторни)
- суматор (∑) – изчислява линейна комбинация от входовете
- праг (θ) – стойност, която определя дали сумата е достатъчна за активиране
- активираща функция (f) – използва се прагова функция (стъпаловидна функция на Хевисайд).
Изкуственият неврон е изчислителна единица, която приема поредица от входове (Хi) и произвежда един изход. Процесът включва три основни стъпки:
- претеглена сума, като всеки вход се умножава по тегло (Wi), което определя неговата важност за крайното решение
- добавяне на отклонение – параметърът θ позволява на мрежата да регулира прага на активиране на неврона
- активационната функция (F) е нелинейна функция, определяща дали невронът ще „се активира“ и каква стойност ще пренесе към следващия слой.
Математически изчислението се представя като:
Output = F ( ∑i=1n xi · wi + θ )

За да илюстрираме принципа, нека разгледаме опростен пример за вземане на решение дали да отидем във Франция, базиран на два фактора (входа):
- x1 : Самолетният билет струва по-малко от $1000
- x2: Вашият партньор може да дойде с вас.
Всеки вход има „тегло“ (w), което определя неговата важност. Ако сте с ограничен бюджет, цената е важна, затова задавате тегло w1 = 4. Ако присъствието на партньора е по-малко важно, задавате w2 = 3. Невронът изчислява претеглена сума и я сравнява с праг (b – 4). Функцията за решение изглежда така:
(x₁ * 4) + (x₂ * 3) – 4 > 0
Представено като вектори на възможните състояния (x1, x2):
- (0,0): (0*4) + (0*3) – 4 = – 4 < 0 → не отиваме
- 1,0): (1*4) + (0*3) – 4 = 0 → прагът не е преминат
- 0,1): (0*4) + (1*3) – 4 = – 1 < 0 → не отиваме
- 1,1): (1*4) + (1*3) – 4 = 3 > 0 → активиране (отиваме)
Въпреки своята революционност, M-P невронът има съществени недостатъци:
- фиксирани тегла и няма механизъм за обучение (теглата се задават ръчно)
- линейна сепарабилност – може да решава само проблеми, които са линейно разделими
- бинарни данни – работи само с дискретни стойности 0 или 1, което ограничава приложението му при сложни непрекъснати сигнали.
Този пример показва, че елементарни изчислителни единици могат да извършват сложни логически операции, което е фундаменталният принцип на цифровата изчислителна техника. В мозъка на човека обаче има около 86 млрд. неврона и не можем да постигнем много с изграждането на математически модели само на един от тях. Решението е в една по-сложна математическа структура, наречена невронна мрежа.
Перцептронът е невронна мрежа с една от най-простите структури от три слоя – входен, скрит и изходен слой. Входният слой включва входните сигнали/променливи. Решаваща е ролята на скрития слой, в който се кодират връзките между входните и изходните величини, открити чрез машинното обучение. От особено значение е възможността да се представят нелинейни зависимости.

Ранните модели (като Перцептрона на Розенблат от 1958 г.) са използвали „твърди“ прагове – или се активира (1), или не (0). Реалният свят обаче е пълен с несигурност и затова учените въвеждат т.н. сигмоидна функция, която преобразува суровите числови сигнали в плавен диапазон от 0 до 1, който позволява на модела да изчисли точно колко трябва да се променят теглата при всяка стъпка на обучение, за да се минимизира грешката.
σ(y) = 1 / ( 1 + e–y )
С това изкуствения интелект може да изразява степен на увереност – например „има 85% вероятност това изображение да е танк“.
Едни от първите реални приложения на тези алгоритми исторически са били използвани именно от военните за работа на радарните системи. Нека си представим, че имаме оръжейна система, работеща с невронна мрежа, изобразена по-горе, която трябва да отговори на въпроса да изстреляме ли ракета по засечения обект? (1 = Огън!, 0 = Не стреляй!):
- Входен слой – предоставя суровите данни, които радарът улавя за летящия в небето обект, като x1 е скорост (дали е бързо и бавно), x2 е височина (дали е високо или ниско) и х3 е радарно сечение (голям или малък).
- Скритият слой има междинни „мозъчни центрове“, които търсят специфични заплахи. Всяко зелено кръгче получава данни от всички сензори едновременно, но им придава различна важност (това са черните линии, наречени тежести). Първият зелен неврон може да е обучен да разпознава крилати ракети. Той ще следи най-вече за специфична комбинация – малък размер (x3) + ниска височина (x2) + висока скорост (x1). Вторият зелен неврон може да е специализиран за тежки бомбардировачи. Той ще търси голям размер + голяма височина. Третият може да има задачата да филтрира ята птици (ниска скорост + малък размер + ниска височина) и да праща сигнал на системата да ги игнорира.
- Изходен слой y събира рапортите от всички „офицери анализатори“ (зелените неврони от средния слой) и въз основа на тях трябва да вземе крайното решение – пускаме ли ракетата или не.
- Функциите за активация (дясната част на картинката). Изходният y решава това въз основа на математическите пресмятания. Тук идва разликата в двете графики вдясно. Горната графика (твърд праг на Розенблат) може да се опише със стара, безкомпромисна автоматизирана система. Командирът събира данните и ако те преминат определена числова граница, дори с частица от процента, синята линия скача директно от 0 на 1. Системата автоматично извежда 1 (ОГЪН!). Проблемът тук идва в нюансите. Ако пътнически самолет лети малко по-бързо от нормалното поради силен попътен вятър, системата с твърд праг може да прескочи границата и директно да стреля по цивилна цел. Затова долната графика, изобразяваща нелинейна активация – сигмоида, прави системата по-модерна и интелигента. Тя не дава сляп отговор „Да/Не“, а използва онази плавна, S-образна оранжева линия, за да превърне данните във вероятност за заплаха. Вместо да стреля сляпо, системата пресмята данните y = (x1. w1) + x2 .w2) + (x3.w3) + b и слагайки полученото число в сигмоидата го преобразува в процент между 0 и 1, казва: „Има 0,92 (92%) вероятност това да е вражески изтребител“. Това позволява да се направят различни протоколи за действие – под 0,30 игнорирай (вероятно птици или метеорологичен балон), от 0,30 до 0,80 вземи на прицел и опитай радиовръзка (може да е приятелски самолет с повреден транспондер), над 0,80 вдигай тревога.
Освен това, тази плавност на сигмоидата позволява на системата да се обучава по време на симулации. Ако на тренировка алгоритъмът каже „90% сигурен съм, че е враг“ за приятелски изтребител, програмистите (или самият компютър) могат леко да намалят силата на онези черни линии (тежестите) при зелените неврони. Следващият път системата ще каже 80%, после 50%, докато не се научи да дава правилен резултат (близо до 0) за приятелски цели.
Впоследствие невронната мрежа може се учи съвсем сама с процес, наречен backpropagation, или обратно разпространение. Като цяло невронните мрежи имат както фундаментални предимства, така и недостатъци. Основните предимства се обуславят от тяхната възможност за извличане на зависимости от данни чрез машинно обучение, като невронните връзки могат да бъдат нелинейни. Съществува теоретично доказателство, че можем да открием всяка аналитична зависимост с достатъчен брой неврони и скрити слоеве (Hornik, Stinchcombe & White 1989). Освен това те имат способността да се самоорганизират и да откриват вътрешните структури в данните.
Основните недостатъци са, че те се превръщат в т.н. „черна кутия“, което не е приемливо за някои среди като отбраната. Невронните мрежи не могат да предсказват добре извън диапазона на данните за обучение — дори малко отклонение извън тези диапазони довежда до неточни предсказвания или дори сриване на модела. За постигане на добра генерализация са необходими значителни количества обучителни данни. Невронните мрежи се употребяват в области като маркетинг за насочване на клиенти, нелинейно управление на процеси с икономически ефект, намаляване на емисиите на парниковите газове, откриване на измами и дезинформация, медицински приложения и автомобилна индустрия.
3.4. Дълбоко обучение и дълбоки невронни мрежи
В началото на XXI в. на основата на невронните мрежи се изгражда най-успешният модерен метод на изкуствения интелект, наречен дълбоки невронни мрежи (Deep Neural Networks). Основната идея е да се генерират сложни модели чрез добавяне към невронната мрежа на голямо количество скрити слоеве с различна архитектура (Goodfellow, Bengio & Courville, 2016). Тази йерархична структура позволява на мрежата да разбира сложни модели стъпка по стъпка:
- входен слой – приема суровите данни (напр. 65 536 неврона за изображение 256×256 пиксела)
- скрити слоеве – извършват междинна обработка. Първите слоеве разпознават ръбове и ъгли, следващите – форми, а последните – цели обекти (напр. танкове или самолети)
- изходен слой – предоставя финалната прогноза или класификация.
Този подход, вдъхновен от зрителната кора на мозъка, позволява постигането на точност над 99% при задачи като анализ на почерк и разпознаване на образи. Днес съществува голямо разнообразие от алгоритми за дълбоко обучение на невронни мрежи, които са подходящи за различни дейности, като разпознаване на изображения, генериране на текст и други.

3.4.1. Конволюционни невронни мрежи (CNN) за разпознаване на образи
Конволюционната невронна мрежа (Convolutional Neural Network, CNN) е основната архитектура на дълбоките невронни мрежи за обработка на изображения. Главната операция, наречена конволюция, извлича прости характеристики като линии, ъгли и ръбове в оригиналното изображение. След това има блок за максимално обединяване, който подсилва и улавя най-важните характеристики. После пак се прави още една конволюция с по-сложни характеристики и се подсилват, докато се постигне надеждна класификация в последния слой. CNN използват филтри (ядра), за да извличат характеристики от входа, използвайки метод, известен като конволюция. Те са гръбнакът на компютърното зрение и системите за автоматично разпознаване на цели в отбранителните приложения.

Представете си, че гледате огромна и много размазана снимка на която трябва да открием вражески танк и търсим с лупа, обхождайки картата сантиметър по сантиметър. Ето как работи конволюционната невронна мрежа стъпка по стъпка:
- Конволюция (търсене на детайли). В мрежата нашата лупа е специален филтър (ядро). Този филтър е програмиран да реагира само на определени неща – например на права хоризонтална линия. Когато лупата мине през място, където има линия, тя „светва“. Първите слоеве на CNN намират само прости неща – чертички, точки и ъгли. Това е като да се види, че на снимката има нещо метално и дълго (може би оръдие?).
- Максимално обединяване. Намирането на всички чертички например води до натрупване на твърде много информация. Следва разделяне на снимката на малки квадратни сектори (например 2 х 2 пиксела) и преценка коя от дадени 4 точки свети най-силно. Оставя се най-силният резултат и останалите се изхвърлят. Резултат се състои в това, че снимката става по-малка и по-лесна за обработка, но най-важните характеристики (ръбовете на танка) стават по-видими.
- Дълбочина – от чертички към обекти. След първия блок процесът се повтаря, но става по-умен. Втората конволюция не търси просто чертички, а събира чертичките от предния слой и разпознава форми (например кръг от колело или верига). Третата конволюция вече събира формите и „вижда“ цялата купола на танка. С всеки следващ слой мрежата разбира все по-сложни обекти.
В една модерна ракета или дрон CNN работи в реално време, като на входа е камерата на дрона, която подава хиляди снимки. AI „филтрира“ шума (дървета, трева) и търси специфични геометрични форми на военна техника. След това системата игнорира маловажните детайли (като цвета на тревата) и се фокусира върху силуета на машината. Накрая, в последния слой мрежата, установява с 99% сигурност, че това е Т-72, а не трактор.
3.4.2. Рекурентни невронни мрежи (RNN) за последователни задачи
Докато обикновената мрежа гледа снимка и казва „това е танк“, рекурентната невронна мрежа (Recurrent Neural Networks – RNN) гледа поредица от събития, подобно на видео. Тя има цикъл (обратна връзка). Когато обработва текущата стъпка, тя добавя към нея „бележка“ от това, което е видяла преди малко. Използват се за обработка на последователни данни –такива, които са в строго определен ред, като естествените езици. Докато класическите невронни мрежи обработват отделни информационни точки, RNN поддържат важната структура и взаимовръзки в рамките на последователните данни.
Представете си, че четете изречение. Човек не чете всяка дума като отделен остров, а помни началото на изречението, за да разбере края му. Ако прочетеш думата „той“, веднага очакваш глагол. RNN обработва входната последователност x = (x₁, x₂, …, xₜ) стъпка по стъпка. На всяка времева стъпка t, скритото състояние hₜ се изчислява с натрупване като функция от текущия вход xₜ и предходното скрито състояние hₜ₋₁:
hₜ = ϕ (Wₕhₜ₋₁ + Wₓxₜ + b),
където xt е сегашният вход, думата, която чете в момента;
ht-1 – миналото, спомен за всичко, което е прочел досега;
ht – nовият спомен, смесва новата дума със стария спомен и получава актуализирана „картина“ в главата си;
Wₕ и Wₓ – тегловни матрици, b е вектор на отместването, а ϕ е активационна функция.
Проблемът на тези мрежи е, че страдат от изчезващия градиент, защото имат къса памет. При обучението се използва Backpropagation Through Time (BPTT), нещо като верига от хора, които си предават съобщение шепнешком (градиента). Ако веригата е много дълга и всеки човек предава съобщението малко по-тихо (малки стойности в матриците), докато се стигне до първия човек, съобщението вече е пълна тишина (нулева промяна). В резултат мрежата спира да се учи от началото на изречението и помни само последните думи.

Този вид мрежи са подобрени с някои разновидни архитектури, като тези на Дългата краткосрочна памет (LSTM – Long Short-Term Memory), проектирана да преодолее този проблем чрез въвеждането на клетъчно състояние (Cₜ) и сложен гейтов механизъм. Компонентите на LSTM клетката включват:
- Забравяща порта – определя каква част от предходното клетъчно състояние Cₜ₋₁ да бъде запазена
- входна порта – регулира каква нова информация да бъде добавена в клетъчното състояние
- изходна порта – определя коя част от клетъчното състояние да бъде изведена като скрито състояние hₜ.

Благодарение на тази структура, LSTM мрежите успяват да поддържат стабилни градиенти при много дълги последователности, което ги прави незаменими при анализ на реч, машинен превод и откриване на аномалии в сложни системи за сигурност.
3.4.3. Генеративните състезателни мрежи (GANs) и теория на игрите
Съществуват и т.н. генеративни състезателни мрежи (Generative Adversarial Networks – GANs). Тази архитектура е предложена от Иън Гудфелоу през 2014 г. Тези мрежи се основават на теорията на игрите, по-конкретно на минимаксните игри с нулева сума, където две невронни мрежи (генератор и дискриминатор) се обучават едновременно чрез взаимна конкуренция, състезавайки се помежду си.
Теорията на игрите е клон от математиката, предложен от Джон Наш през 1949 г., който изучава стратегическото вземане на решения. Тя се прилага в ситуации, в които крайният резултат за един участник (играч) зависи не само от неговите собствени действия, но и от действията на останалите участници. В науката „игра“ не означава забавление, а всяка ситуация с играчи (участници, които вземат решения), техните стратегии и печалби. Резултатът е награда или наказание за всяка комбинация от стратегии.
Това може да се онагледи с известната дилема на затворника, която илюстрира защо двама души или организации може да не си сътрудничат, дори когато това е в техен общ интерес. Според условието имаме двама души (А и Б), заловени и разпитвани в отделни стаи. Полицията няма достатъчно доказателства и предлага на всеки следното:
- ако ти предадеш другия, а той мълчи – ти излизаш на свобода, а той влиза в затвора за 10 години
- ако и двамата мълчите (сътрудничество) – и двамата влизате само за по 1 година
- ако и двамата се предадете един друг (дефекция) – и двамата влизате за по 5 години.
От гледна точка на индивида, най-безопасно е да предаде другия (за да избегне 10-те години). Тъй като и двамата мислят така, те се предават взаимно и получават по 5 години. Ако бяха се доверили и мълчали, щяха да получат само по 1 година. Извод: В егоистична среда рационалните индивиди често избират стратегия, която води до по-лош общ резултат. Това може да се играе, докато се постигне Равновесието на Наш. Това е състоенето, при което никой от играчите няма стимул (изгода) да промени своята стратегия, докато другият държи собствената си непроменена.

Разновидност на тази игра е минимакс играта, когато имаме стратегия за вземане на решения в игри с двама играчи и нулева сума (където печалбата на единия е равна на загубата на другия). В контекста на Генеративните състезателни мрежи (GANs) дискриминаторът се опитва да максимизира познаването на истината, а генераторът се опитва да направи така, че успехът на дискриминатора да е минимален (да го измами). Това „дърпане на въже“ е чиста минимаксна игра, която води системата към перфектни резултати.
Представете си, че имате двама фалшификатори, които се надпреварват. Това е в основата на GANs. Генераторът създава данни (например снимки на лица), които изглеждат напълно истински, въпреки че не са реални. дискриминаторът гледа снимки и определя: „Това е истински човек“ или „Това е фалшификат, направен от генератора“. Първоначално генераторът създава просто шум и драсканици. Дискриминаторът го сравнява с истински данни. Ако познае, че е фалшификат, той дава „обратна връзка“ на генератора. Генераторът се учи от грешката си и следващия път прави по-добро копие. Това продължава, докато генераторът стане толкова добър, че дискриминаторът започне да гадае напосоки (50/50 шанс). Това е равновесието на Наш, при което вече имаме почти истинска снимка.

В контекста на военното дело и киберсигурността, GAN се използват за създаване на реалистични симулации и генериране на данни за обучение на алгоритми за разпознаване на цели. Имат широка употреба за противодействие на дезинформацията, разработване на модели за откриване на deepfakes. Чрез обучение на дискриминатори върху генерирано съдържание се подобрява способността за идентифициране на манипулирани видео- и аудиозаписи.
Теорията на игрите може да се използва и във военното дело, например за анализ на стратегии при надпреварата на държавите във въоръжението. Две държави биха били по-добре, ако харчат пари за болници вместо за ракети (това е състояние на сътрудничество). Ако едната се въоръжава, другата е длъжна да го прави, за да не бъде уязвима. Така Равновесието на Наш е и двете да харчат милиарди за оръжия – по-лош резултат за всички, но математически „стабилен“. Такъв е примерът с ядреното сдържане по време на Студената война, при което никой не печели.
уствения интелект тренираме невронната мрежа, като променяме теглата x1, x2, x3, … , xn и пристрастията b. Това означава, че променяме входовете, за да сведем до минимум функцията за загуба. Това не е по-различно от простата линейна регресия. Не забравяйте, че функцията за загуба е само разликата между прогнозираната стойност и наблюдаваната стойност. Когато има само 1 или 2 входа, това е лесно. Но с разпознаването на ръкописен текст има стотици или хиляди входове. (За изображение от 256 пиксела има 256 * 256 входа в нашата невронна мрежа, изглежда нещо подобно, с изключение на това, че това е направено по-малко, за да можете да го визуализирате. И тази мрежа гледа само цифрите, а не цялата азбука.)
Tози вид невронна мрежа се обучава чрез изчисляване на разликата между действителния изход и желания изход. Задачата за математическа оптимизация тук има толкова измерения, колкото са регулируемите параметри в мрежата – предимно теглата на връзките между невроните, които могат да бъдат положителни [сини линии] или отрицателни [червени линии].

Обучението на мрежата по същество намира минимум от тази многомерна функция „загуба“ или „цена“. Това се прави итеративно в продължение на много тренировъчни писти, като постепенно променя състоянието на мрежата. На практика това предполага извършването на много малки корекции на теглата на мрежата въз основа на изходите, които се изчисляват за случаен набор от входни примери, като всеки път се започне с тежестите, които контролират изходния слой и се движи назад през мрежата. (Тук са показани само връзките към един неврон във всеки слой, за простота.) Този процес на обратно разпространение се повтаря в много случайни набори от примери за обучение, докато функцията за загуба не бъде сведена до минимум и мрежата след това осигурява най-добрите резултати, които може за всеки нов вход.
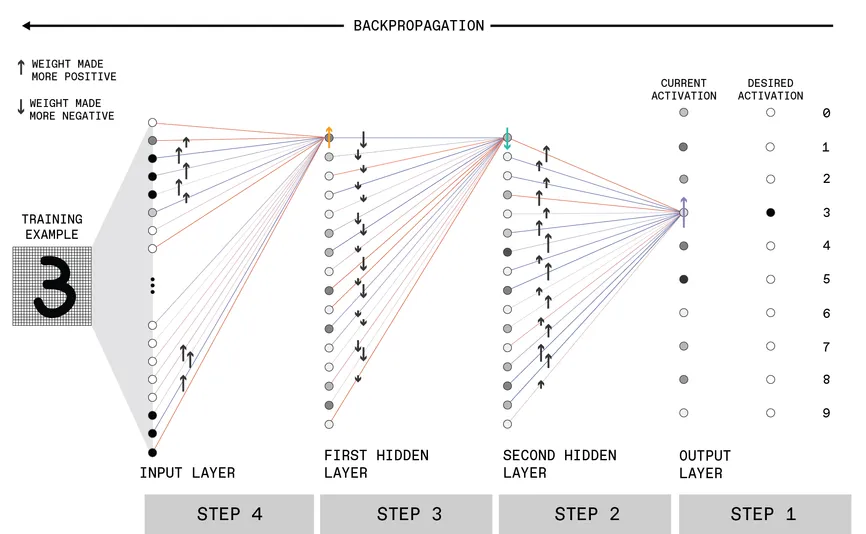
СТЪПКА 1
Когато са представени с ръкописно „3“ на входа, изходните неврони на нетренирана мрежа ще имат случайни активации. Желанието е изходният неврон да се свърже с 3, да има висока активация [тъмно засенчване] и други изходни неврони да имат ниски активации [светло засенчване]. Така че активирането на неврона, свързан с 3, например, трябва да се увеличи [лилава стрелка].
СТЪПКА 2
За да направите това, теглото на връзките от невроните във втория скрит слой към изходния неврон за цифрата „3“ трябва да бъде направено по-положително [черни стрелки], като размерът на промяната е пропорционален на активирането на свързания
скрит неврон.
СТЪПКА 3
След това подобен процес се извършва за невроните във втория скрит слой. Например, за да се направи мрежата по-точна, може да се наложи активирането на горния неврон в този слой да бъде намалено [зелена стрелка]. Мрежата може да бъде избутана в тази посока чрез регулиране на теглата на връзките си с първия скрит слой [черни стрелки].
СТЪПКА 4
След това процесът се повтаря за първия скрит слой. Например, първият неврон в този слой може да се наложи да увеличи активирането си [оранжева стрелка].
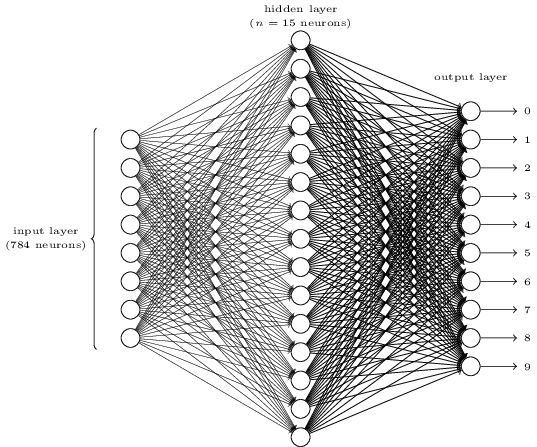
При проста линейна регресия функцията на загубата е разстоянието между наблюдаваната стойност z и прогнозираната стойност p, или z – p. При невронните мрежи използваме нещо по-сложно, наречено стохастично градиентно спускане, което не е необходимо да се разбира. Достатъчно е да се каже, че в общи линии е едно и също нещо. Но намирането на минималната стойност в някаква функция с хиляди входни променливи е трудно постижимо, така че стохастичното градиентно спускане първо прави предположение и след това работи оттам.
Майкъл Нилсен дава тази аналогия. По-долу е дадена графика на функция за загуба f(x,y), т.е. функция с два входа. Ако пуснете мрамор в тази купа, той ще се търкаля до най-ниската точка. Стохастичното градиентно спускане е алгоритъм за намиране на тази точка за функция на загуба с много входни променливи. (За тези, които знаят смятане, може да се каже защо просто не вземете производната на тази функция и не намерите нейния минимум? Отговорът е, че не можете лесно да намерите производната за функция с хиляди променливи.)
Разпознаване на изображения с невронни мрежи
Невроните са прости линейни уравнения с изход 1 (вярно) или 0 (невярно). Точно този пример не е удачен при задачи за разпознаване на изображения, защото малките промени в теглата и пристрастията водят до големи промени в изхода. В края на краищата за тази цел се използват коефициенти, например 0,2 до 0,65. Да предположим, че имаме проста невронна мрежа с две входни променливи x1 и x2 и отклонение от 3 с тегла – 2 и -3. Уравнението за това е:
Ако -2×1 + -3×2 + 3 < 0, тогава 1 (вярно) в противен случай 0 (невярно).
(Това не е точно правилният начин да се изрази това в алгебрата, но е нагледен пример. Целта тук е да се сведе математиката до минимум, за да стане по-лесна за разбиране.)
Машинното обучение регулира теглата и отклоненията, докато получената формула най-точно изчислява правилната стойност. Не забравяйте, че това е все едно да кажете, че коригирането на тежестите и пристрастията намалява функцията за загуба до нейния минимум. Повечето проблеми с ML работят например с линейна регресия.
И така, как да избегнем голямата промяна от 0 към 1, което би объркало нашия модел? Позволяваме входни и изходни числа между 0 и 1 вместо само 0 или 1. Най-простият начин да направите това е да разделите уравнението на числото 1, като използвате подобна формула, като тази, използвана от логистичната регресия. И тогава приемаме конвенцията, че ако крайната изходна стойност на невронната мрежа има праг, да речем 0,5, тогава можем да заключим, че резултатът е 1.
Но не е ли това просто заобиколен начин за изчисляване на нещо, което води до 0 или 1? Не. Защото в невронната мрежа няма само входните начални стойности и получения изход. В средата има междинни стъпки, наречени скрити слоеве. Те не трябва да се оценяват на 0 или 1.
Както и да е, нека сега видим как работи това с разпознаването на ръкописен текст. Ето изображение на числото „0“. Невронната мрежа разглежда всеки пиксел и колко тъмен е пикселът, за да разбере кои пиксели са попълнени. След това сръвнява това с образци на почерк, за които е известно, че представляват числото 0. Тренировъчният комплект взема образци например от 350 души. Тези данни вземат комбинацията от пиксели на всеки чертеж и показват дали е 0, 1, 2, …, или 9. След това невронната мрежа се обучава, въз основа на тези данни, т.е. коригира коефициентите и пристрастията, докато най-точно определи коя е цифрата.
3.4.4. Области на приложение на дълбоките невронни мрежи
Мрежите за дълбоко обучение са основната технология, която позволява на ИИ да общува с хората чрез обработка на изображения, разпознаване на звуков говор и анализ на естествен език. Широкият спектър от възможности за приложение се основава на уникалната способност за автоматично генериране на йерархия от свойства с нарастваща сложност. Многобройните възможности за избор на различни архитектури допринасят за успеха.
Недостатъци на дълбоките невронни мрежи са, че те се разглеждат като „черна кутия“, а някои дълбоки невронни мрежи имат повече от 100 слоя и 40 млн. параметъра. Разработването на такъв модел изисква много време дори на най-мощния хардуер. Те се нуждаят от големи масиви от данни за обучение, понякога от порядъка на милиони записи. Области на приложение на дълбокото обучение са в обработката на естествен език (NLP) – онлайн търговия на дребно, търсачки, интерфейси човек – машина, автоматични преводи, разпознаване на лица, медицинска диагностика, медии и развлечения.

Съвременният изкуствен интелект оказва огромно въздействие в три ключови области – на науката, бизнеса и обществото. Този факт трябва да се разбере много добре, за да сме подготвени да се възползваме или да се предпазим от новата реалност. Изнесените факти категорично посочват бъдещата тенденция, особено към дигитална икономика, основана на изкуствения интелект.
Заедно с вълната на внедряване на изкуствения интелект в обществото се очертават три важни области, където човешкият интелект е най-уязвим за инвазията на технологиите – етиката на изкуствения интелект, управлението на изкуствения интелект и дълбоката фалшива реалност, генерирана от него. В списъка на най-важните етични проблеми и страхове фигурират въпросите за потенциалната масова безработица, породена от поголовната автоматизация, контрола върху автономните системи, всеобхватните възможности за следене на индивида, свръхинтелигентните оръжия и др. Друг критичен въпрос е контролът върху системите на изкуствения интелект. Той ще става все по-актуален в бъдеще, ако се доближим до обобщения изкуствен интелект.
Съвременните направления в изследванията са дълбокото подсилено обучение, когнитивните модели и невронните системи. Изкуственият интелект демонстрира огромен ръст в почти всяка област на приложение в индустрията и много агресивно прониква в обществото. В крайна сметка изкуственият интелект е от изключителна важност и значение за всички компоненти на нашия живот.
AI, като инструмент в националната сигурност
Комбинирането на AI с байесовски разсъждения може да помогне за прогнозиране на събития без исторически опит за анализ
едки бедствия от типа „черен лебед“ като земетресения или пандемии, които се оказаха трудни за прогнозиране, могат да станат предвидими с помощта на AI, открива ново проучване.
Необичайни събития като измамни вълни или горски пожари могат да имат тежки последици. Въпреки това, тяхната рядкост означава, че има малко исторически данни за прогнозни модели, които да анализират, за да прогнозират точно кога могат да се случат в бъдеще. Освен това тези събития често изглежда възникват от неизвестен набор от физически условия, което прави прогнозирането им аналогично на намирането на игла „в безмерна купа сено“, отбелязва проучването.
Сега изследователите предложиха нова стратегия за преодоляване на тези предизвикателства. Той обединява AI, който обикновено разчита на тонове данни за обучение, със статистическия подход, известен като Bayesian reasoning, при който предварителното знание помага да се изчислят шансовете, че несигурният избор може да е правилен.
Целта на тази комбинация е да се определи кои биха могли да бъдат най-полезните данни, когато става въпрос за точни прогнози за редки събития. Въпросът е да се възползваме максимално от оскъдните данни. По същество качеството на точките от данни може да помогне да се компенсира липсата на количество, което потенциално позволява да се направи повече с по-малко.
„Обикновено AI се нуждае от изобилни данни, за да бъде успешен“, казва водещият автор на изследването Итън Пикъринг, изследовател в областта на машинното обучение, сега в Bayer Crop Sciences в Кеймбридж, Масачузетс. „С нашия подход са необходими само малко количество внимателно подбрани данни, за да се осигурят точни и надеждни резултати.“
Предишни изследвания за прогнозиране на екстремни събития се фокусираха върху разработването на уравнения за правилно моделиране на сложните системи, които пораждат тези събития. Въпреки това, „управляващите уравнения на тези системи са изключително чувствителни към шума и предположенията, което означава, че дори внимателно изработените модели, базирани на физиката, често се провалят и са невъзможни за прилагане на практика“, казва Пикъринг. Още по-лошо, тези управляващи уравнения „обикновено са неизвестни за системите от реалния живот, за които ни е грижа, оставяйки ни без физични методи, за да разберем тези явления“
Вместо това учените разчитаха на AI системи, които правеха прогнози въз основа просто на данни. „AI предоставя гъвкава възможност да прескочим това фундаментално предизвикателство, основано на уравнения, и да базираме разбирането си за тези системи на наблюдаваната истина“, казва Пикъринг. „Препятствието в това обаче е, че се нуждаем от достатъчно данни, за да може AI ефективно да разбере сложната система, която искаме от нея да моделира.“
В новото проучване изследователите експериментират с дълбока невронна мрежа, наречена DeepONet. Невронната мрежа е съставена от изчислителни възли, свързани заедно по начин, който грубо имитира връзките между невроните в човешкия мозък. Невронната мрежа се нарича „дълбока„, ако притежава няколко слоя възли.
По-конкретно, DeepONet е дълбок невронен оператор. Тази разновидност на AI системата се състои от две невронни мрежи в една, обработващи данни в две паралелни мрежи. Тази архитектура му помага ефективно да научи как работят физическите системи.
„Използването на ансамбъл от дълбоки невронни оператори води до количествено определяне на несигурността, което позволява на нашия подход да работи добре“, казва Пикъринг.
Учените отбелязват, че техният подход помага да се анализират рисковете от редица редки сценарии, включително оценка на шансовете за опасни пикове на случаите по време на пандемия, откриване кои привидно доброкачествени вълни могат да доведат до опасни измамни вълни и оценка кога корабът може да се счупи наполовина поради стрес.
Пикеринг и колегите му открили, че новият им метод превъзхожда традиционните усилия за моделиране, когато става въпрос за прогнозиране на тези събития. „Бяхме просто изненадани колко добре работи нашият подход за всяка система, която опитахме, включително много, които не са описани в статията, както и много сложни системи“, казва Пикъринг.
В бъдеще учените биха искали да използват стратегията си, за да помогнат за прогнозирането на бедствия, които днешните компютърни модели предполагат, че ще дойдат с изменението на климата.
„Ще дам актуален пример, тъй като тази година, 2023 г., очакваме Ел Ниньо да инициира значително увеличение на екстремните метеорологични събития, а именно урагани“, казва Пикъринг. Стратегията на изследователите, заедно с компютърните модели на ураганите, може да помогне за „ефективно разкриване на вероятните и катастрофални сценарии, за които обществото трябва да се подготви през 2023 г.“ и „може да се използва и за откриване на оптималните сценарии за смекчаване на екстремните събития, които сега са изключително полезни за справяне с входящите бедствия“.
Предизвикателство, пред което са изправени изследователите, когато става въпрос за прогнозиране на бедствия, свързани с изменението на климата, е „дали проблемите, от които се интересуваме, просто все още са твърде сложни“, предупреждава Пикъринг. „Дори ако намалим количеството данни, необходими за разбирането на системата, това количество данни [което е необходимо] все още може да е твърде много, за да ги генерираме. Въпреки това, с много квалифицирани учени, работещи с алгоритми като нашия, може да успеем да намалим сложността по подходящ начин и да намерим работещи решения на нашите големи климатични предизвикателства. „
Препоръчана литература: 2023.05_Natalia_Marinova.pdf (eknigibg.net)
Бележки
- MACLEOD, H. Information vs. Knowledge [онлайн]. Gapingvoid, 14 януари 2014. [Прегледан на 3 юни 2026]. Достъпен на: gapingvoid.com