Урок 4 от 25
Алгоритми в ИИ
Аз знам, че нищо не знам
Сократ
В света на изкуствения интелект (ИИ) думата автомат се отнася до компютър, който може да бъде проектиран да решава конкретна задача, например да дава прогнози за борсови пазари. Андроидът е автомат, който е създаден така, че да имитира човешко поведение.
Първоначално тестът на Тюринг се фокусира върху цифровата интелигентност, но съвременните учени смятат, че ИИ трябва да демонстрира всеки един от осемте вида интелигентност – речева, артистична, цифрова, сензорна, пространствена, емоционална, физическа и рефлективна (Gardner, 1983).
Идеята, че всяко мислене – било то човешко или изкуствено – е форма на изчисляване, по-конкретно процес по използване на алгоритми за превръщане на символна информация на входа в символна информация на изхода, се нарича „изчислителна теория на ума“ (Putnam 1960; Fodor 1975). Нейните поддръжници твърдят, че човешкият мозък е компютър и поради тази причина един ден изкуственият интелект ще е способен да прави всичко, което може и човешкият мозък.
Алгоритъмът е поредица от инструкции за решаване на задача. В него има вход (входяща информация или данни) и процеси. Обработката се състои от поредица от стъпки за постигане на желан резултат или изход (Knuth 1968). Може да бъде всичко – от обикновено изчисление, през следване на готварска рецепта, до решаване на сложни математически уравнения. Тя е пример за това, което математиците наричат „ефективен метод“, което означава, че се състои от краен брой стъпки и създава конкретен отговор (или изход).
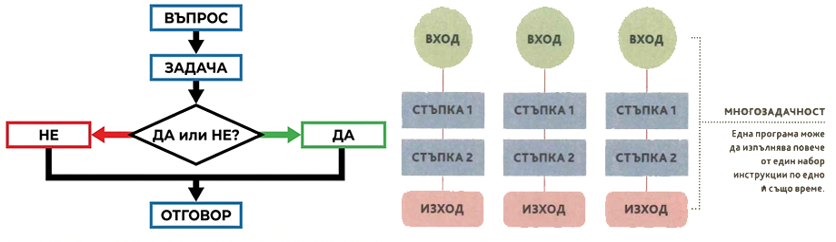
Фигура 33. Алгоритъм
Изчислението следва стъпките на алгоритъма. Най-елементарният пример е аритметичното изчисление. Например, ако събирате две трицифрени числа наум, вие следвате поредица от стъпки – алгоритъм – за да получите резултат. Изчисленията използват символи, за да изобразят числа, но със символи може да се изобрази почти всичко. С правилните символи и алгоритми стават възможни изключително сложни изчисления.
През 19 век сложната работа по изготвянето на числовите таблици (за нуждите на навигацията, военното дело и др.) се възлага на хора, наричани изчислители (на англ. „компютри“). За да се избегнат човешките грешки, английският математик Чарлз Бабидж (1791 – 1871) изобретява „диференчната машина“, която може автоматично да извършва математически изчисления. След това създава проект за „аналитичната машина“ – калкулатор за обща употреба, който може да се програмира с перфорирани карти и има отделни компоненти, свързани с паметта и с изчисленията (Babbage 1837). „Аналитичната машина“, която Бабидж така и не изгражда на практика, поставя теоретичните основи на модерните компютри.
През 1936 г. английският математик Алън Тюринг (1912 – 1954) предлага въображаема машина, способна да реши всяка задача, която може да се сведе до „изчислим вид“ (Turing 1936). С други думи, ако задачата се напише в символен вид, с помощта на алгоритми и преведена в бинарен код, хипотетичната машина би могла да я реши. Устройството се състои от глава, която се движи над лента, маркирана с бинарна информация. Макар и никога да не е конструирана, „универсалната машина“ на Тюринг слага началото на компютърната революция, като доказва, че едно-единствено устройство може да реши всяка задача, която има изчислим вид. След това различните решения за изчислителни машини на база на теорията на Тюринг са били предимно механични, докато българинът Джон Атанасов, заедно със своя асистент Клифърд Бери, създава първия електронен цифров компютър – ABC, конструиран между 1939 и 1942 г.
Маккълок и Питс (1943) демонстрират, че мрежа от елементи, наподобяващи човешките нервни клетки (невроните), по които протичат електрически сигнали, може да имитира машината на Тюринг. Те допускат, че мозъкът може би е вид жив компютър, което означава, че един „електрически мозък“ може да изпълнява същите програми като човешкия. Тази теория е известна и под името „множествена реализируемост“. Съвременната наука за машинното обучение е разработила многообразие от алгоритмични методи, които могат да бъдат систематизирани в десет основни семейства според функционалните характеристики и математическите основи (Mitchell 1997; Alpaydin 2010; Flach 2012; Bishop 2006):
| № | Семейство | Описание | Ключови методи |
|---|---|---|---|
| 1. | Регресионни методи | Предсказване на непрекъснати числени стойности | Линейна регресия, полиномна регресия, метод на най-малките квадрати |
| 2. | Методи, базирани на инстанции | Съхраняване на обучителни примери и сравнение чрез мерки за сходство | k-Nearest Neighbors (k-NN), Locally Weighted Learning |
| 3. | Методи за регуляризация | Разширения на регресионните подходи с ограничения върху сложността | Ridge Regression, LASSO, Elastic Net |
| 4. | Методи, базирани на дървета | Рекурсивно разделяне на пространството на признаците | CART, ID3, C4.5, техники за подрязване |
| 5. | Байесовски методи | Явно прилагане на теоремата на Бейес | Наивен Бейес, Bayesian Belief Networks, максимална правдоподобност |
| 6. | Ядрени методи | Нелинейни трансформации във високомерни пространства | Support Vector Machines (SVM) с различни ядрови функции |
| 7. | Клъстерни методи | Автоматично групиране на данни | K-Means, йерархично клъстериране, Expectation-Maximization (EM) |
| 8. | Асоциативно-правилно обучение | Откриване на правила, описващи големи части от данните | Apriori, Eclat |
| 9. | Намаляване на размерността | Компресиране на информацията | Principal Component Analysis (PCA), Linear Discriminant Analysis (LDA), автоенкодери |
| 10. | Ансамблови методи и невронни мрежи | Комбиниране на няколко модела | Bagging, boosting, random forests, многослойни перцептрони, конволюционни и рекурентни невронни мрежи |
Разбирането на оптимизационните алгоритми и механизмите на обучение е първата стъпка към ефективното внедряване на интелигентни системи. Повечето от тях се използват за търсене, планиране и оптимизация. Във фигура 34 е представена класификация на този вид алгоритми.
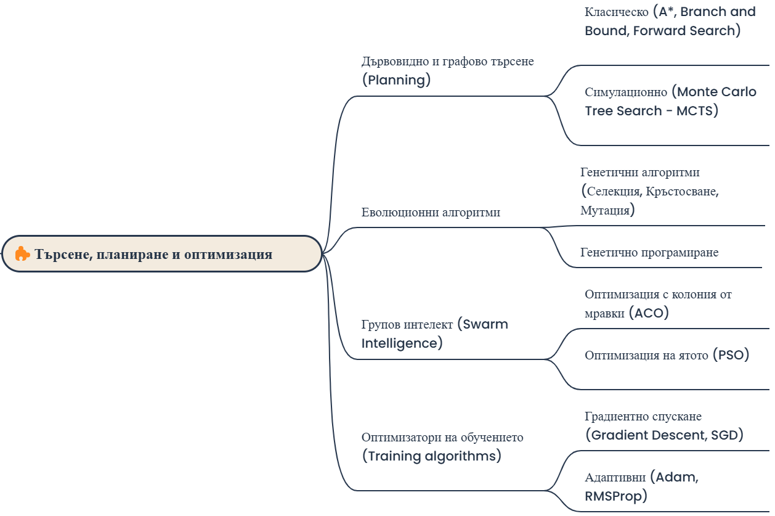
Фигура 34. Класификация на алгоритми за търсене, планиране и оптимизация
Алгоритми за групиране без учител (K-means, Йерархична клъстеризация)
Клъстеризацията е метод от обучението без учител, чиято цел е групирането на обекти в множества (клъстери) по такъв начин, че обектите в един и същи клъстер да бъдат по-подобни помежду си, отколкото на тези в други клъстери. В контекста на националната сигурност и киберсигурността, този метод се прилага за откриване на аномалии, класификация на зловреден софтуер или анализ на дезинформационни кампании.
В областта на машинното обучение, клъстеризацията представлява процес на групиране на обекти по такъв начин, че тези в една и съща група (наречена клъстер) да са по-сходни помежду си, отколкото с тези в други групи. Този метод се класифицира като неконтролирано обучение, тъй като алгоритъмът работи с немаркирани данни и не разполага с предварително дефинирана зависима променлива. Основната цел на всеки алгоритъм за клъстеризация е едновременното постигане на две условия:
- максимизиране на вътрешнокласовото сходство;
- минимизиране на междукласовото сходство, което математически се изразява чрез максимизиране на разстоянието между центровете на клъстерите.
За измерване на сходството най-често се използва Евклидово разстояние между две точки p и q в n-мерно пространство:
d(p, q) = √( ∑i=1n (qi − pi)² )
Разлика между класификация и клъстеризация. Класификацията и клъстеризацията звучат сходно, но са два различни метода на изкуствения интелект. Класификацията се използва при контролирано обучение (когато имаме зависима променлива и маркирани данни), докато клъстеризацията се използва при неконтролирано обучение, когато нямаме никакви познания за зависимата променлива и данните не са маркирани (Mitchell 1997). Тъй като задачата за клъстеризация е субективна, средствата, които могат да се използват за постигането ѝ, са много. Всяка методология следва различни правила за определяне на метриката на сходство между точките с данни. Известни са повече от 100 алгоритъма за клъстеризация, но в повечето бизнес проблеми се прилагат два – йерархична и k-Means клъстеризация (Bishop 2006).
Както подсказва името, йерархичната клъстеризация е алгоритъм, изграждащ йерархия от клъстери, която може да бъде представена чрез дървовидна структура. Резултатите от йерархичната клъстеризация могат да бъдат показани с помощта на дендрограма. Дендрограмата може да се интерпретира, като започваме в основата с n точки данни, всяка от които е разпределена в отделни клъстери. Най-близките клъстери се обединяват, докато се получи само един клъстер в горната част. Височината в дендрограмата, при която се сливат два клъстера, представлява разстоянието между два клъстера в пространството на данните.
Алгоритъмът започва, разглеждайки всяка точка като отделен клъстер. На всяка стъпка се сливат двата най-близки клъстера, докато всички точки не бъдат обединени в един общ клъстер. Височината на сливане в дендрограмата съответства на разстоянието между клъстерите. Потребителят може да „отреже“ дендрограмата на определено ниво, за да получи желания брой групи.
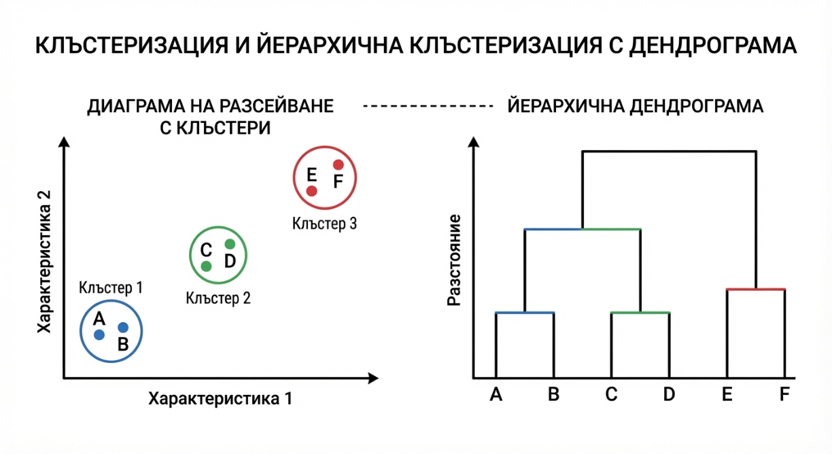
Фигура 35. Пример за клъстеризация и дендограма на йерархична клъстеризация
Алгоритъм K-means е итеративен алгоритъм, който разделя набора от данни на K на брой предварително дефинирани клъстера. Целевата функция, която алгоритъмът се опитва да минимизира, е сумата от квадратите на разстоянията в рамките на клъстерите (Within-Cluster Sum of Squares – WCSS):
J = ∑j=1K ∑x∈Sj ‖x − μj‖²
- K е броят на клъстерите;
- Sj е множеството от точки в j-тия клъстер;
- μj е центроидът (средната стойност) на точките в Sj.
Алгоритмичните стъпки са:
- инициализация на K случайни центроида;
- причисляване на всяка точка към най-близкия центроид;
- преизчисляване на позициите на центроидите като средноаритметично на всички точки в съответния клъстер;
- повторение на процеса до конвергенция (когато позициите на центроидите спрат да се променят).
Целта на K-means е да се намерят групи в данните, като броят на групите се представя от променливата K (брой на клъстерите), определена от потребителя. Алгоритъмът работи итеративно, за да причисли всяка точка от данни към една от K групите въз основа на предоставените характеристики. Точките данни се групират въз основа на сходството на признаците (Alpaydin 2010). Започва се с избиране на желания брой клъстери. Алгоритъмът K-means инициализира процеса със случайни центрове в данните и след това се опитва да прикрепи най-близките точки към тези центрове. Предимство на този алгоритъм е, че центровете на K клъстерите могат да се използват за маркиране на нови данни.
Ще илюстрираме приложението на K-means клъстеризацията с интересно бизнес приложение за анализ на причините за възникването на икономически проблеми при резки и значителни промени на икономиката. Предприятие от химическата промишленост иска да разбере как различните икономически фактори са повлияли на ефективността на бизнеса преди и след голямата рецесия през 2008 г. Хипотезата е, че двете различни икономически състояния преди и след рецесията ще бъдат представени в различни клъстери.
Събирането на данни включва 42 макро-, микро- и свързани с бизнеса фактори за няколко тримесечия около рецесията. Резултатите от прилагането на K-means показват, че двата клъстера са ясно дефинирани, без да има припокриване между тях, т.е. има ясно разграничение между факторите при двете икономически състояния. Важно е също, че тримесечните данни по време на рецесията, представляващи прехода между двете равновесни състояния в икономиката, са извън клъстерите. Това означава, че сравнението и анализът на поведението на бизнеса се основават на икономическото равновесие преди и след рецесията.
Оптимизацията като математическа дисциплина може да ни помогне да намерим минимум или максимум на дадена функция. Има два вида оптимума – локални (в определен район на пространството за търсене) и глобални (в цялото пространство за търсене). В повечето реални ситуации обаче не е лесно да се разграничи локалното от глобалното оптимално решение.
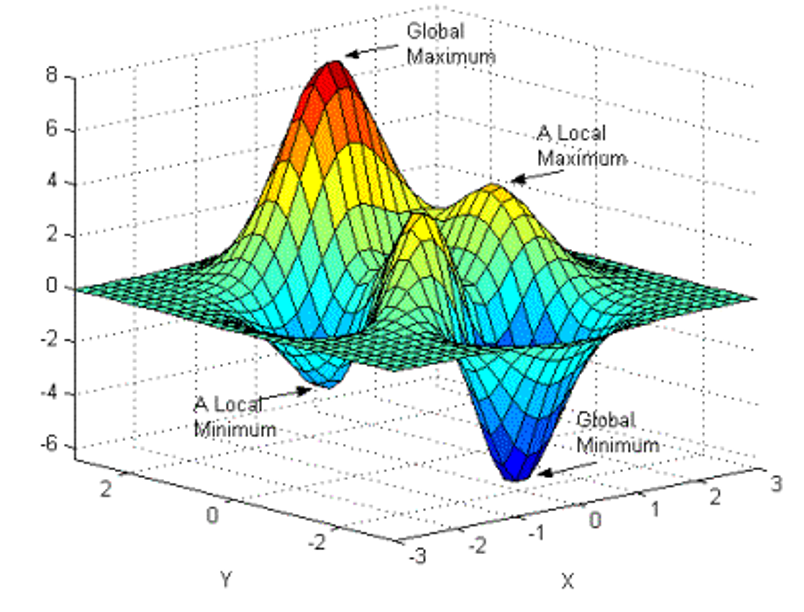
Фигура 36. Визуализация на глобални и локални минимуми и максимуми
Проблеми на класическата оптимизация. В класическия тип оптимизация се опитваме да намерим оптимума на дадена функция въз основа на нейните частни производни. Първите частни производни, съставящи градиента, помагат да определим посоката на най-близкия локален минимум. Вторите частни производни, съставящи т.нар. матрица на Хесен (Хесиан), ни помагат да определим позицията на локалния минимум. Всичко това работи, ако можем да изчислим тези частни производни. Ако не можем, се изправяме пред голям проблем. За съжаление това се случва често в реални ситуации. Тези числени методи работят много добре само ако разполагаме с т.нар. гладко пространство за търсене. Ситуацията е коренно различна при търсене в негладкото, шумно пространство с много оптимуми. Преди всичко не е лесно да се направи разграничение между глобалния оптимум и локалните оптимуми. От изчислителна гледна точка пространството за търсене не позволява да изчислим надеждно частните производни, т.е. губим основния навигатор към оптимума. Заради това сме принудени да търсим други алгоритми, небазирани на производни.
Изкуственият интелект разполага с три основни метода, които ни позволяват да прилагаме оптимизация в области, където класическата оптимизация обикновено се затруднява да даде решения (Mitchell 1997):
- генетични алгоритми (Genetic Algorithms – GA);
- оптимизация с колония от мравки (Ant Colony Optimization – ACO);
- оптимизация с интелигентност на ятото (Particle Swarm Optimization – PSO).
Еволюционни алгоритми
Еволюционните алгоритми представляват разнообразие от методи, вдъхновени от идеята на Дарвин, че процесите на еволюция могат да бъдат формализирани и приложени като алгоритми в изкуствена среда (Darwin 1859; Holland 1975). Ключовата концепция е симулацията на естествен отбор и наследственост, при която популация от потенциални решения на даден проблем претърпява селекция, кръстосване и мутация във виртуалното пространство на компютъра. Така с всяко поколение еволюират и се усъвършенстват решения – независимо дали става дума за уравнения, електронни схеми, механични конструкции или алгоритми за намиране на оптимални пътища.
Този подход обхваща различни техники и парадигми, сред които генетичните алгоритми, генетичното програмиране, оптимизацията с интелигентност на ятото (Particle Swarm Optimization) и мравешките колонии (Ant Colony Optimization), които ще бъдат разгледани по-детайлно. Всеки от тези методи прилага в различна степен принципите на еволюцията, за да намери ефективни и адаптивни решения на сложни проблеми в разнообразни области на науката и техниката.
Генетични алгоритми – популация, селекция, кръстосване и мутация
Генетичните алгоритми представляват категория методи за търсене и оптимизация, вдъхновени от законите на биологията и представени в абстрактна математическа форма. В контекста на отбраната, те се използват за решаване на сложни задачи, при които традиционните математически методи са неефективни – от проектиране на аеродинамични форми до оптимизиране на логистични вериги. Една от важните характеристики на еволюционните алгоритми е, че вместо да се работи с едно решение в пространството за търсене, се разглежда едновременно голяма популация от множество решения („индивиди“).
За да се разбере работата на генетичния алгоритъм, е необходимо дефинирането на ключови понятия, които правят паралел между биологията и инженерната оптимизация:
- популация – множество от възможни решения (индивиди), които се разглеждат едновременно;
- генотип (хромозома) – вътрешното представяне на решението (обикновено като цифров код);
- фенотип – физическата реализация на решението (например конкретна форма на крило на дрон или параметри на двигател);
- фитнес функция (оценка на жизнеспособността) – математически критерий, който определя колко „добро“ е дадено решение спрямо поставената цел.
Всяка генна структура в един генетичен алгоритъм може да бъде представена като популация от хромозоми, всяка от които е проектирана като набор от гени. На тази биологична основа стъпва идеята за определяне на пространството за търсене за оптимизация на базата на генотиповете на хромозомите от пространството на решенията, където се намира физическият обект на процеса на оптимизация.
С помощта на генетичния алгоритъм се търсят най-добрите от възможните решения. Процесът прилича на симулирана еволюция на конкуриращи се структури в компютъра. На по-добрите решения се позволява да имат „деца“, а по-лошите се елиминират. Новите решения наследяват характеристиките на своите „родители“ с някои случайни вариации и след това на по-добрите от тях се позволява също да имат потомство, докато по-лошите „умират“. След определен брой поколения компютърът съдържа решения, които са значително по-добри от отдавна елиминираните си предци.
Процесът на намиране на оптимално решение преминава през няколко последователни фази:
- Инициализация. Алгоритъмът стартира с множество потенциални решения, събрани в една „популация“. Компютърът генерира начална популация от случайни решения. Например, ако проектираме свръхзвукова ракета и искаме да определим нейните физически характеристики, като размер на крилата, тежест и други, ние взимаме формулата за закона за движение на ракета и някои параметри оставяме плаващи, като искаме алгоритъмът да определи техните размери, за да получим най-висока скорост.
- Оценяване. Всяко решение на това уравнение се подлага на тест чрез фитнес функцията (в нашия случай – най-високата скорост). Слабите решения (поколения) получават ниска оценка, а тези, които се доближават до търсеното решение – висока.
- Селекция. Следва процес на естествен подбор, при който на решенията с висока жизнеспособност се дава възможност да имат „наследници“. На по-добрите решения се дава по-голям шанс да станат „родители“ и да прехвърлят своите характеристики в следващото поколение. Слабите решения се елиминират и уравнението се решава отново.
- Генетични оператори. Това е същността на еволюционния подход, където се прилагат генетични вариации. На всяко решено уравнение се оставят параметрите с получена най-добра скорост и останалите се кръстосват и мутират отново и отново:
- кръстосване – оператор, при който избраните участъци от хромозомите на родителите се разменят в потомството. Тази обмяна на информация между две „родителски“ решения създава „потомство“, съчетаващо техните силни страни;
- мутация – оператор, който променя малка част от хромозомите. Това е случайна промяна в характеристиките на новото решение, използвана главно за поддържане на разнообразието от структури и предпазване на алгоритъма от попадане в еднотипна популация (стагнация).
- Итерация. Породеното поколение еволюира и се образува ново множество потенциални решения, а старото поколение се унищожава. Този процес (генерация на поколение) се повтаря многократно, при което решенията стават все по-добри до намиране на търсения екстремум или докато се изчерпи времето за изчисления.
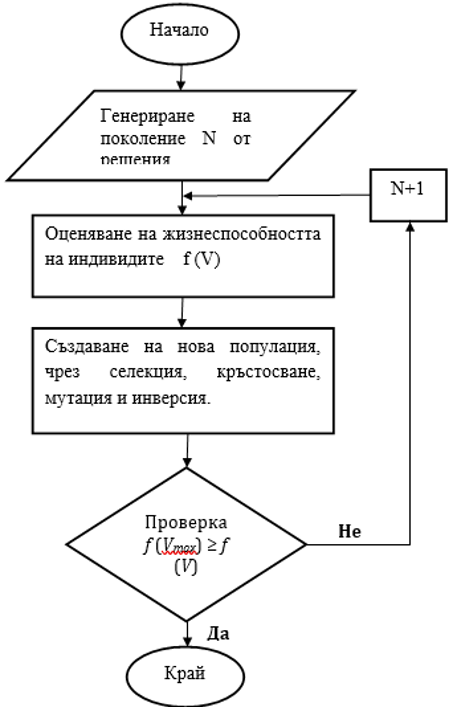
Фигура 37. Последователност на генетичен алгоритъм
В резултат на ключовите генетични операции средното качество на цялата популация и най-вече на най-добрите видове по време на симулираната еволюция постепенно се увеличава и в крайна сметка алгоритъмът ни казва, че за да получим най-добрата скорост на движение, изследваните параметри на ракетата следва да бъдат с дадени x размери. За изясняване работата на алгоритъма, ще разгледаме още един условен пример за избор на компютърни икони, използвани в нова програма, които трябва да се харесват на потребителите. В началото на алгоритъма тази популация е от случайни видове иконки.
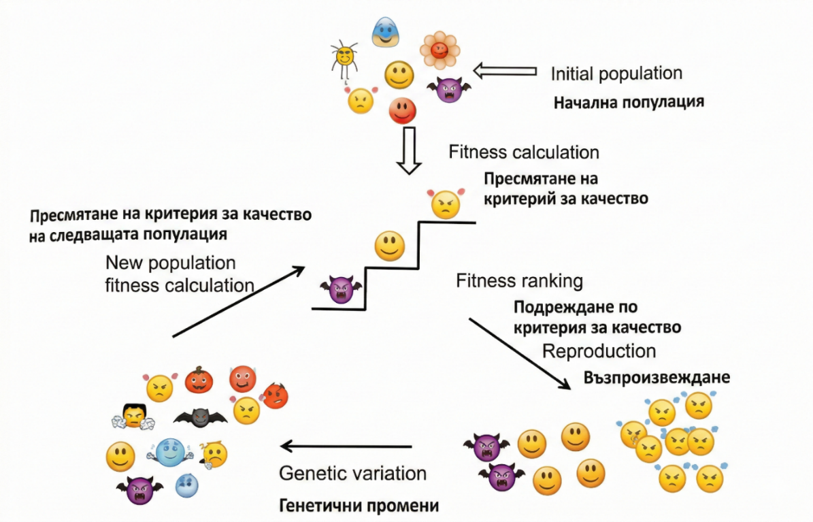
Фигура 38. Пример за работата на генетичен алгоритъм. Източник: КОРДОН, А., 2023. Перспективата изкуствен интелект. Изток-Запад. ISBN 978-619-01-1251-8.
- Стъпка 1 (ранкиране). Първата стъпка е те да бъдат класифицирани според критерий за качество – например „грабване на внимание“. В резултат иконката на жълтото човече има най-висок ранг, следва кафявото човече и т.н.
- Стъпка 2 (възпроизвеждане). Даваме по-големи права за възпроизвеждане на иконките с по-висок ранг.
- Стъпка 3 (вариации). Прилагаме генетичните операции кръстосване и мутация. В резултат се създават частично нови иконки към текущата популация.
Преминаваме към следващия цикъл на симулираната еволюция с пресмятане на критерия за качество на новата популация. В следващото ранкиране очакваме иконките, които грабват повече внимание, да имат по-силно присъствие поради конкурентното си предимство. Еволюционният алгоритъм е безкраен цикъл, където някои от тези иконки оцеляват, други се елиминират и непрекъснато се модифицират. В резултат цялостната популация повишава своето качество.
Най-популярните два метода на този вид оптимизация са:
- Генетични алгоритми (Genetic Algorithms – GA). Използват се предимно за оптимизация на параметри (напр. намиране на най-добрите размери на даден детайл). Това е оптимизационен метод, базиран на еволюционни принципи. Първата важна стъпка е подреждане на популацията от случайни дигитални обекти (образи, уравнения, схеми и т.н.) по избран критерий за качество. С всеки следващ кръг на еволюцията сложността на популацията нараства и се появяват членове с по-високо качество.
- Генетично програмиране (Genetic Programming – GP). Използва се за предсказване и генериране на нови структури. Вместо да търси числа, GP създава алгоритми или програмни кодове, които решават специфични задачи. Фокусът е върху генерирането на нови структури и взаимоотношения, основани на конкуренцията. В случая с генетичното програмиране това са уравнения, които са оптимални по отношение на грешката и са възможно най-прости. Точността и сложността са определящите критерии за оцеляване, затова и изборът на нови решения е фокусиран върху т.нар. Парето фронт.
В генетичното програмиране и оптимизацията често се сблъскваме със ситуации, в които няколко цели едновременно (многоцелева оптимизация) си противоречат. Например, искаме дронът да бъде едновременно лек (за икономия на гориво) и здрав (за издръжливост). Няма едно-единствено „перфектно“ решение, което да е най-добро и по двата показателя. Тук идва понятието Парето фронт (кръстен на италианския инженер Вилфредо Парето).
Парето фронтът е множеството от всички онези решения, които са „ненадминати“ (недоминирани). Това означава, че за никое от тези решения не съществува друго решение, което да е по-добро във всички показатели едновременно. Представете си, че оптимизираме стол чрез генетичен алгоритъм с две цели – максимална здравина при минимална цена.
- Решение А: Много здрав, но много скъп;
- Решение Б: Евтин, но крехък;
- Решение В: Средна здравина, средна цена;
- Решение Г: По-слабо от А и по-скъпо от А. (Това е лошо решение, то не е в Парето фронта.) Решения А, Б и В са част от Парето фронта, защото не можем да кажем кое от тях е категорично по-добро – едното е по-добро по цена, а другото по здравина.
В генетичното програмиране (GP) алгоритъмът търси уравнения, които са баланс между точност (да предсказват добре) и простота (да са кратки и разбираеми). Парето фронтът показва на инженера най-добрите компромиси, от които той може да избира спрямо конкретните нужди на мисията.
Въпреки че и двата метода използват едни и същи еволюционни принципи (популация, кръстосване, мутация, селекция), тяхната структура и цел са коренно различни. Генетичният алгоритъм работи по принцип с низ от числа, за да намери точни пропорции, а генетичното програмиране работи с динамични структури. Решението не е просто списък от числа, а компютърна програма, формула или дърво на решение. Дължината и сложността на структурата могат да се променят (растат или намаляват) по време на еволюцията.
Уникално свойство на еволюционните алгоритми е техният неограничен потенциал да генерират нови решения за почти всеки практически проблем. Те могат да генерират модели с оптимален баланс между точност и сложност. Това е най-добрият сценарий за крайния потребител, тъй като приложените емпирични модели могат да бъдат интерпретирани и при малки промени в производствените процеси или бизнес условията.
Техните предимства са, че са напълно автономни и не изискват човешка намеса. Разходите за разработване са минимални, тъй като надеждният модел се генерира автоматично. За разлика от класическите методи, не се „заклещват“ лесно в локални, неоптимални решения. Могат да оптимизират системи с хиляди променливи едновременно. Получените емпирични решения са явни математически функции, които могат да бъдат реализирани във всяка софтуерна среда, включително Excel. И не на последно място – имат ниски разходи за внедряване и поддръжка.
Недостатъците им се състоят в това, че симулираната еволюция изисква значителна изчислителна мощност. Непрекъснатото нарастване на изчислителната мощност съгласно Закона на Мур постепенно решава този проблем. Необходимо е продължително време за генериране на решение – неизбежен ефект от интензивното изчисление. Процесът е по-бавен в сравнение с повечето методи на изкуствения интелект. Не са много ефективни, когато пространството за търсене е изключително голямо. За предпочитане е броят на променливите да бъде ограничен до 1000, а броят на записите – до 1 млн., за да се получат резултати за приемливо време.
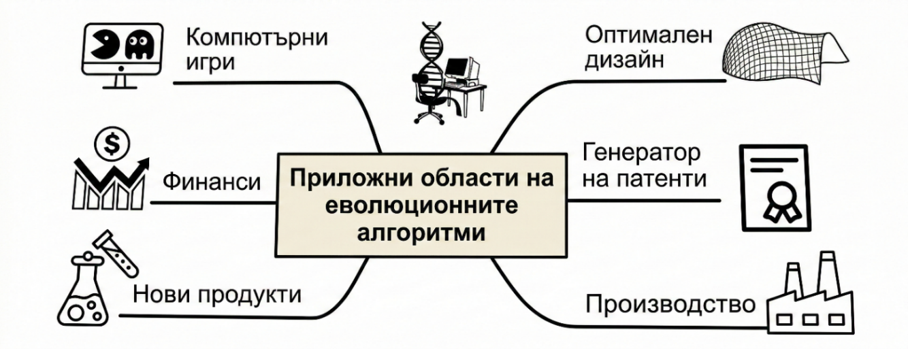
Фигура 39. Приложни области на еволюционните алгоритми
Бизнес потенциалът на еволюционните алгоритми в областта на инженерното проектиране беше бързо осъзнат в началото на 90-те години от компании като General Electric, Rolls Royce и BAE Systems plc. В рамките на няколко години много отрасли, като авиационната, енергийната и химическата промишленост, трансформираха интереса си към еволюционните изчисления в практически решения.
Най-прилаганата област е т.нар. оптимален дизайн. Типичен пример е прилагането на генетичен алгоритъм за предварително проектиране на газови турбини и оптимизиране на геометрията на отворите за охлаждане на турбините в Rolls-Royce. Целта е била да се сведе до минимум разходът на гориво. Чрез симулирана еволюция компютърът оптимизира геометрията, постигайки резултати, които често надминават възможностите на класическото инженерно проектиране.
Групов интелект
Груповият интелект представлява нов начин за оптимизиране и класифициране на сложни системи в реално време чрез имитация на социално взаимодействие в различни биологични общества. Има две основни направления в изследванията на груповия интелект и неговото приложение (Mitchell 1997):
- Оптимизация по метода на колонията от мравки (Ant Colony Optimization – ACO) – основаваща се на интелигентността на колонията от насекоми;
- Оптимизация на базата на ято (Particle Swarm Optimization – PSO) – основаваща се на социалното взаимодействие в птичите ята или на рибни пасажи.
Оптимизация по метода колония от мравки (ACO)
Как мравките успяват да намерят най-краткия път? Отговорът от биологията е прост – чрез прилагане на механизма на стигмергия – индиректна комуникация, основана на феромон (субстанция, която оставят) по пътя, който следват. Те използват конкуриращи се маршрути, един от които е значително по-кратък от останалите, където непрекъснато подсилват приложения феромон.
В природата, когато една мравка открие източник на храна, тя се връща в гнездото, маркирайки пътя си с феромон. Други мравки, откривайки тази следа, са склонни да я последват, като на свой ред я подсилват. Мравките по късия път обаче ще извършат повече пътувания и по този начин ще оставят повече феромон по него. Концентрацията на феромона върху късия път ще се увеличава с по-висока скорост, отколкото върху дългия път, и във фазата на напредналото търсене мравките по дългия път ще го избегнат за сметка на по-късия път. Тъй като повечето мравки вече няма да пътуват по дългия маршрут и тъй като феромонът е летлив, следата по дългия път ще започне да се изпарява. Във финалната фаза на търсене остава само най-краткият маршрут.
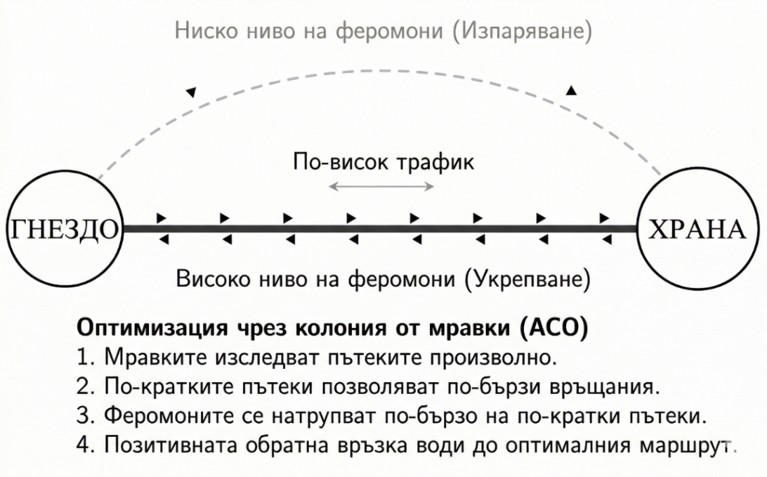
Фигура 40. Последователност на намиране на най-краткия път между гнездото и храната на колония от мравки
Алгоритъмът за оптимизация на принципа на колонията от мравки (Ant Colony Optimization – ACO) представлява мощна метаевристична техника, вдъхновена от тяхното колективно поведение. В основата му заляга концепцията за стигмергия – форма на индиректна координация чрез промени в околната среда.
В изкуствените системи всяка „мравка“ е агент, който конструира решение чрез вероятностен преход между възлите в граф. Вероятността Pijk мравката k да се придвижи от възел i към възел j се дефинира чрез следната зависимост:
Pijk = [ (τij)α · (ηij)β ] ÷ [ Σl∈allowedk (τil)α · (ηil)β ]
- τij е интензивността на изкуствения феромон върху дъгата (i, j);
- ηij – евристичната стойност (обикновено ηij = 1/dij, където d е разстоянието);
- α и β – параметри, определящи относителната тежест съответно на феромонната следа и на евристичната информация;
- allowedk – списъкът с възли, които мравката k все още не е посетила (памет на агента).
Процесът на оптимизация преминава през три основни фази:
- Начално търсене – феромоните са разпределени равномерно или случайно. Мравките изследват пространството на решенията, като се разпределят по различни маршрути.
- Напреднало търсене – благодарение на натрупания опит вероятностите започват да се изкривяват в полза на по-добрите (по-късите) пътища. Започва процес на експлоатация на информацията.
- Финална фаза – алгоритъмът постига сходимост. Поради изпарението на феромона по субоптималните пътища те стават статистически пренебрежими и цялата колония се концентрира върху най-доброто намерено решение.
Този подход е изключително ефективен при решаване на комбинаторни задачи, оптимизация на мрежови трафик и логистично планиране в динамична среда. Процесът създава самоусилваща се обратна връзка, която в крайна сметка насочва цялата колония към оптималния маршрут. Псевдокод на алгоритъма:
- Създаваме колония от n изкуствени мравки по стохастичен начин (със случайни параметри).
- Позволяваме на тези мравки да полагат динамично феромонови следи по време на работа, за да отразят опита си в търсенето.
- Критичният момент в този алгоритъм е как да се вземе решение кой потенциален път да се следва.
Мравката избира следващия възел, към който да се придвижи, като се съобразява с вероятност на феромоновите стойности τ и евристичните стойности η на дъгите, свързващи възел i с възлите j, които все още не е посетила. Посетените възли са запаметени.
Пълният алгоритъм за оптимизация тип колония от мравки се инициализира с популация от цифрови мравки (например 100) със случайни параметри. За всяка мравка се изчислява определен критерий за качество, например разстоянието до някое целево място. В хода на оптимизацията непрекъснато се актуализират стойностите на отложения цифров феромон въз основа на дефинираната евристика. В края на симулацията се разглежда сходимостта на фитнес функцията – например дали пристигаме в определен град за минимално време, минимално разстояние или за минимално количество гориво.
Едно от първите успешни приложения на оптимизацията тип колонии от мравки е намирането на оптимални маршрути за полетите за товарните операции на Southwest Airlines, което им донесе над 10 милиона долара годишна печалба. Освен това той може да се прилага за разпределяне на задачите и планиране на работни места. Може да се използва за изгодно планиране на доставките на втечнен газ, оптимизиране на трафика в телекомуникационните мрежи и др.
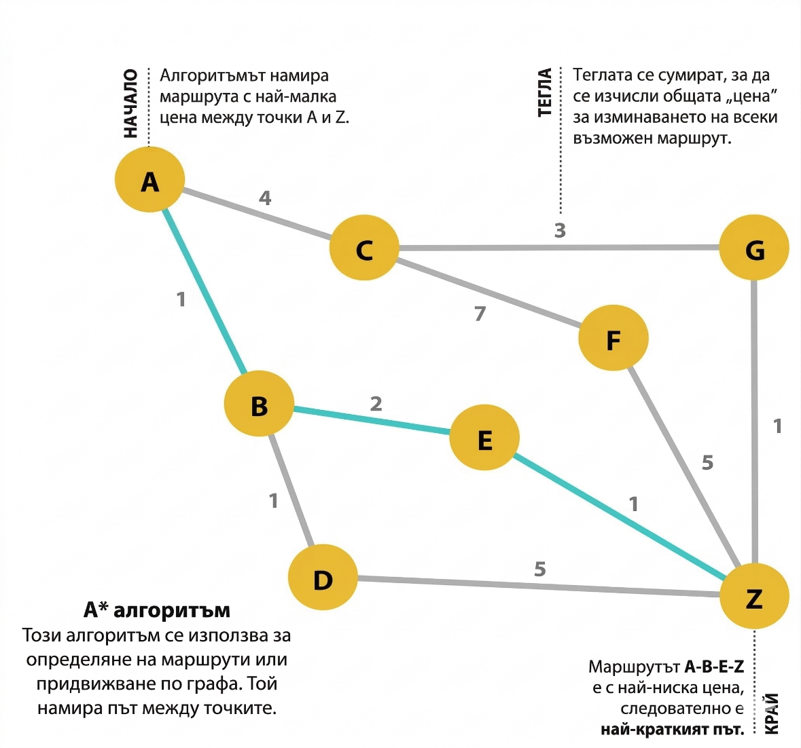
Фигура 41. Алгоритъм A* – намиране на най-кратък път
Евристичен модел „Маршрут през Манхатън“ – този модел картографира маршрутите, като изчислява броя на изминатите вертикално и хоризонтално квадрати. Той може да се използва за намиране на път в град с улична система, наподобяваща мрежа, каквато има Манхатън. За да разберем тази концепция, е необходимо да си представим картата на остров Манхатън в Ню Йорк, където улиците образуват перфектна решетка (мрежа от квадрати). Ако сте на едно кръстовище и искате да стигнете до друго, не можете да минете по диагонал през сградите. Трябва да се движите само хоризонтално (наляво/надясно) и вертикално (нагоре/надолу).
В математиката и програмирането това се нарича манхатънско разстояние. То измерва разстоянието между две точки в мрежа, като събира абсолютната разлика между техните X и Y координати.
Алгоритъмът A* е „умен“, защото не търси сляпо във всички посоки. Той използва евристика (обозначена като h) – обосновано предположение колко остава до целта. Ако алгоритъмът A* се използва в среда, където движението по диагонал е забранено (например в игра, където героят се движи само в 4 посоки по плочки), манхатънското разстояние се използва като перфектната евристика. То „подсказва“ на A* накъде да се насочи, за да намери най-краткия път изключително бързо, без да изчислява излишни маршрути.
Оптимизация по примера на ятото (PSO)
При обучението на изкуствен интелект една от главните цели е да се намерят перфектните „настройки“ (тегла и параметри), така че моделът да прави възможно най-точни предвиждания или решения. Пространството от възможни настройки е огромно – подобно на необятен, невидим планински пейзаж, където целта е да се намери най-ниската долина (най-малката грешка) или най-високият връх (най-високата точност).
Най-популярният алгоритъм за това е оптимизацията чрез рояк частици (Particle Swarm Optimization – PSO), вдъхновен от социалното поведение на ятата птици или пасажите с риби. Принципът на алгоритъма на оптимизация на ятото е по-сложен за обяснение и се базира на актуализиране на скоростта и местоположението на всяка птица със съответните характеристики на водача. Предполага се, че той най-бързо и точно се насочва към оптимума, като работи в следната последователност:
- Алгоритъмът създава множество виртуални „частици“ (птици) със случайни параметри в пространството. Всяка частица представлява едно възможно решение (една конкретна комбинация от настройки за AI модела) и притежава два основни вектора – вектор на позицията xi и вектор на скоростта vi.
- Тези частици биват „пуснати“ да летят из пространството от решения. Движението на частиците е насочено към търсене на глобален оптимум чрез итеративно актуализиране на тези вектори.
- Всички частици общуват помежду си (интелектът на рояка) и знаят кое е най-доброто място, открито от цялото ято към момента, и това, което те са открили за себе си. Критичната стъпка в алгоритъма е да се сравни локалният най-добър резултат на всяка птица с най-добрия глобален резултат на лидера на ятото. С други думи, движението на всяка частица е резултат от суперпозицията на три основни тенденции – инерция (стремеж на частицата да запази посоката си), когнитивно влияние (привличане към собствения исторически успех), социално влияние (привличане от лидера).
- Във всяка стъпка (итерация) всяка частица променя посоката и скоростта си, като се привлича едновременно към своя личен най-добър резултат и към глобалния най-добър резултат на ятото. Извършва се и съответна актуализация на скоростите, в крайна сметка всички птици в ятото са много близо една до друга около глобалния оптимум.
Когато една частица намери много добро решение, тя „привлича“ останалите натам, което води до изключително бърза и ефективна оптимизация на модела. Динамиката на ятото се описва чрез система от уравнения, които дефинират промяната на състоянието на всяка частица i в дискретни моменти от време t:
vi(t+1) = w · vi(t) + c1r1 ( pi,best − xi(t) ) + c2r2 ( gbest − xi(t) )
xi(t+1) = xi(t) + vi(t+1)
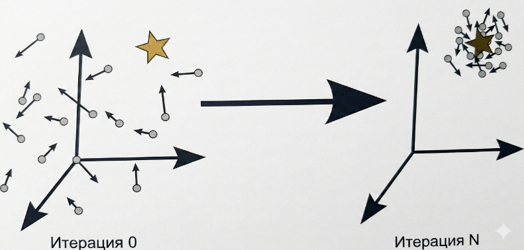
Фигура 42. Теория на ятото
Критична особеност на алгоритъма е способността му за динамична оптимизация. Тъй като той непрекъснато актуализира скоростите въз основа на относителните разлики в позициите, може ефективно да проследява оптимуми, които променят координатите си във времето.
Във военното дело теорията на ятото не се използва само за трениране на софтуер в лабораториите, а се прилага физически на бойното поле за рояци от дронове. Тук изкуственият интелект, базиран на рояка, контролира десетки, стотици или дори хиляди малки машини, които действат като единен организъм. Ако например трябва да се неутрализира вражеска зенитна система, вместо да изпратят един скъп изтребител или голям дрон (който лесно може да бъде засечен и свален), се изпраща рояк от 200 малки, евтини дронове камикадзе. Как интелектът на рояка работи в тази ситуация:
- Децентрализация. В рояка няма един дрон лидер, всеки от тях взема самостоятелни решения на базата на локалните си сензори и комуникацията със съседните му дронове (точно като мравките или птиците). Ако ПВО системата свали 20 дрона, роякът не спира да функционира. Той мигновено се прегрупира и продължава мисията, защото няма централен мозък, който да бъде унищожен.
- Насищане на атаката. Използвайки алгоритми като гореописаните, дроновете в реално време изчисляват откъде да атакуват. Те се разпръскват, за да объркат радарите (които не могат да проследят 200 цели едновременно) и след това изкуственият интелект ги насочва да се сближат към целта от различни ъгли едновременно.
- Колективно разузнаване. Ако един дрон от ятото засече замаскиран радар чрез камерите си, той веднага предава координатите на останалите. Ятото автоматично пренасочва част от ресурсите си, за да унищожи новата заплаха, без нужда от човешка намеса.
За да може един такъв рояк от дронове да работи перфектно на бойното поле (да избягва сблъсъци помежду си, да се съобразява с вятъра и да намира целите), изкуственият интелект, който го управлява, е бил предварително оптимизиран в компютърни симулации, използвайки същата тази математическа теория на ятото. Освен това този алгоритъм може да се използва в контекста на системите за управление – това позволява адаптиране на параметрите в реално време при промяна на външните условия или състоянието на обекта. Също така в киберсигурността PSO се прилага за откриване на аномалии и оптимизиране на ресурси при динамично променящи се заплахи.
В индустрията се прилага за задачи от рода на избор на оптимална структура на невронна мрежа за прогнозиране на цените на електроенергията. Едно от първите медицински приложения на оптимизацията на ятото е за успешна класификация на тремора на ръцете, свързан с болестта на Паркинсон.
Предимствата на груповите алгоритми са, че те могат да се прилагат за оптимизация в условия на висок шум на сигнала и сложни пространства за търсене. За разлика от класическите методи за оптимизация, методите на груповия интелект са прости и принципите им са лесни за прилагане. Въпреки това те все още се нуждаят от задаване на няколко параметъра за настройка, като повечето от тях са специфични за конкретния проблем. Основните недостатъци са, че те са неконтролируеми от ръководните органи, трудно мащабируеми и имат ограничена размерност за работа с данни.