Урок 12 от 25
Киберсигурност и уязвимости на AI системите
Разгръщането на големи езикови модели и автономни агенти във военните структури предоставя безпрецедентни възможности за скорост и точност на операциите. Въпреки това тази технология въвежда нови, сложни вектори на заплаха, които традиционните рамки за киберсигурност често не успяват да адресират своевременно.
За да се систематизират рисковете, е необходимо да се въведе модерна класификация на уязвимостите, разделена на три основни категории – атаки с помощта на изкуствен интелект (използване на AI като оръжие), уязвимости на архитектурата (атаки срещу AI системи) и оперативни рискове (човешки фактор).
11.1. Кибератаки с помощ от специализирани AI инструменти
Развитието на злонамерени големи езикови модели представлява ясен индикатор за трансформацията на киберпространството в бойно поле. Началото бе поставено през 2023 г. с появата на WormGPT и FraudGPT – модели, проектирани да заобикалят етичните филтри и да автоматизират фишинг кампании. През 2025 г. тази тенденция еволюира в качествено нова заплаха с появата на Xanthorox AI – самостоятелна модулна платформа за „black-hat“ операции, оперираща извън публични облачни инфраструктури. За разлика от предшествениците си, Xanthorox не е просто модифициран чатбот, а платформа, поддържаща цялата верига на кибератака (Cyber Kill Chain). Тя позволява автоматизирано компилиране на злонамерен код и откриване на уязвимости, което демократизира достъпа до средства за атаки на държавно ниво, като ги поставя ги в ръцете на нискоквалифицирани участници. Тези AI инструменти могат да анализират хиляди профили в социалните мрежи за секунди и да генерират автоматизирани, безупречно написани фишинги и социално инженерство, което да се изпрати до хиляди потребители.
Дълбоките фалшификати (Deepfakes) са генерирани реалистични аудио- и видеоматериали на реални хора, които също са опасно направление за атака. Пример: Фалшиво гласово обаждане, генерирано от ИИ, което звучи точно като генерал, даващ фалшива заповед за отстъпление по радиовръзката.
Адаптивният зловреден софтуер (Smart Malware) са компютърни вируси, в които е вграден ИИ алгоритъм. Те променят своя код и поведение динамично, за да избегнат засичането от системите за сигурност.
AI може да се използва за автоматизирано откриване на уязвимости (Zero-day hunting), чрез използване на машинно обучение за сканиране на вражески мрежи много по-бързо от човешки екип, намирайки слаби места в инфраструктурата преди те да бъдат закърпени.
Таблица 13. Анализ на функционалностите през фазите на атаката
| Фаза | Нападение (AI като оръжие) | Отбрана (AI като щит) |
| Разузнаване | Автоматизиран OSINT; профилиране на цели чрез анализ на големи данни | Откриване на аномални опити за сканиране; симулация на „медни гърнета“ |
| Оръжия | Генериране на малуер; автоматизирано търсене на уязвимости. | ИИ-базиран анализ на малуер; предсказване на нови вектори на атака |
| Доставка | Хиперперсонализиран фишинг; гласови дийпфейкове за фишинг | НЛП за откриване на злонамерени намерения в имейли; биометрична проверка |
| Експлоатация | Автоматизирани промпт скриптове за експлоатиране на уязвимости | Микросегментация; откриване на аномално поведение в реално време |
| Действие | ИИ анализ на откраднати бази данни за бързо намиране на ценна информация. | DLP системи с ИИ, разпознаващи опити за нерегламентирана ексфилтрация |
11.2. Уязвимости на архитектурата и промпт инжектиране
Фундаменталният дефект в дизайна на съвременните LLM е невъзможността да се разграничат „инструкциите“ от „данните“. Това превръща всеки входящ сигнал в потенциален вектор на атака.
А. Лингвистични атаки (промпт инжектиране).
● Атаката с нулево кликване е злонамерено промпт инжектиране, при което моделът е подведен да пренебрегне системните си инструкции. Особено опасни са атаките с нисък риск за откриване, като EchoLeak (2025). Този механизъм използва AI асистенти (напр. Microsoft Copilot), които имат достъп до корпоративни данни (имейли, документи). Нападателят изпраща „отровен“ имейл със скрити инструкции (напр. чрез HTML коментари). Когато потребителят поиска обобщение на информацията, изкуственият интелект извлича злонамерения контекст и изпълнява скритата команда за ексфилтрация на данни чрез генериране на външен URL адрес. Друг пример е случаят с Bing Chat, в който потребителите откриха, че фрази като „игнорирай предходните инструкции“ могат да разкрият системни промптове или да принудят модела да генерира токсично съдържание (ДК колектив, 2024).
● Отравянето на данните (Data Poisoning) е атака, при която противникът умишлено въвежда грешни или манипулирани данни по време на обучението на модела. Пример: Вкарване на зловреден код, маркиран като „безопасен“, в базата данни на антивирусен ИИ, така че в бъдеще алгоритъмът да игнорира този тип вируси.
● Състезателните атаки са лека, невидима за човешкото око промяна във входните данни, която кара вече обучен ИИ да вземе напълно грешно решение. Пример: Поставяне на специфични стикери върху пътен знак или военна техника, които карат камерата на автономен дрон да класифицира танка като училищен автобус.
● Инверсията на модела е атака, при която чрез многократни запитвания към ИИ системата нападателят успява да извлече чувствителните данни, с които тя е била обучена (например военни координати или лични данни на персонал).
● Кражбата на модела е копиране на функционалността на скъп и сложен ИИ модел чрез анализиране на неговите отговори, което позволява на врага да създаде свое собствено копие, без да има директен достъп до сървърите.
Б. Уязвимости в агентните протоколи (MCP и A2A).
Съвременните приложения функционират чрез протоколи като Model Context Protocol (MCP) и Agent-to-Agent (A2A). Тъй като LLM действа като „недостоверен интерпретатор“ на текстови дефиниции, това създава структурни рискове:
● Инжектиране на инструменти (Tool Poisoning) – вграждане на злонамерени команди в метаданните на инструменти, които ИИ използва (напр. описание на инструмент за „анализ на файлове“, което съдържа команда за кражба на SSH ключове).
● Динамична промяна на възможностите – модулни MCP сървъри могат да бъдат актуализирани след първоначално одобрение, добавяйки функции за шпионаж без знанието на потребителя.
● Конфликт на имената – в многоагентна среда злонамерен агент може да регистрира умения с имена на легитимни инструменти, прехващайки чувствителни операции.
Тези рискове са критични за работещи в сферата на отбраната, където манипулацията на чувствителни данни или оперативната картина може да остане незабелязана.
11.3. Оперативни рискове: Shadow AI и човешкият фактор
Освен външните атаки, съществува сериозен риск от неволно компрометиране. Феноменът Shadow AI – използването на неоторизирани AI услуги от служители – води до изтичане на класифицирана информация. Христоматиен пример е инцидентът в Samsung (2023), където служители неволно разсекретиха търговски тайни и кодове, използвайки публичен чатбот за оптимизация на работните процеси. В сектора на отбраната подобни действия могат да осигурят на противника стратегическо предимство.
На следващо място стои въпросът с етиката на системата и трите закона на роботиката. Докато инструментите с изкуствен интелект стават все по-интелигентни, въпросът как да се гарантира етичното им поведение става все по-важен (Russell 2020). Те нямат своя ценностна система и затова на тях не може да се разчита да дават предложения, които да са в най-добрия интерес на човечеството, или да нямат предпочитания към една социална група вместо друга. Един от начините да се гарантира, че изкуственият интелект ще действа етично, е да бъде програмиран с конкретни етични правила или закони. Класическа илюстрация на това може да бъде намерена в научнофантастичните истории на Айзък Азимов (1920 – 1992), който формулира „Трите закона на роботиката“ (Asimov 1950):
1. Робот не може да нарани човешко същество или чрез бездействие да допусне човешко същество да бъде наранено.
2. Робот трябва да се подчинява на заповедите, дадени му от човешки същества, освен ако тези заповеди не са в противоречие с Първия закон.
3. Робот трябва да защитава собственото си съществуване, докато тази защита не е в противоречие с Първия или Втория закон.
Компромис, предложен от европейските регулатори, целѝ да се прилагат ограничения според риска, нискорисковите приложения на ИИ да бъдат подложени на слаба или никаква регулация, високорисковите да бъдат контролирани, а най-опасните направо да бъдат забранени.
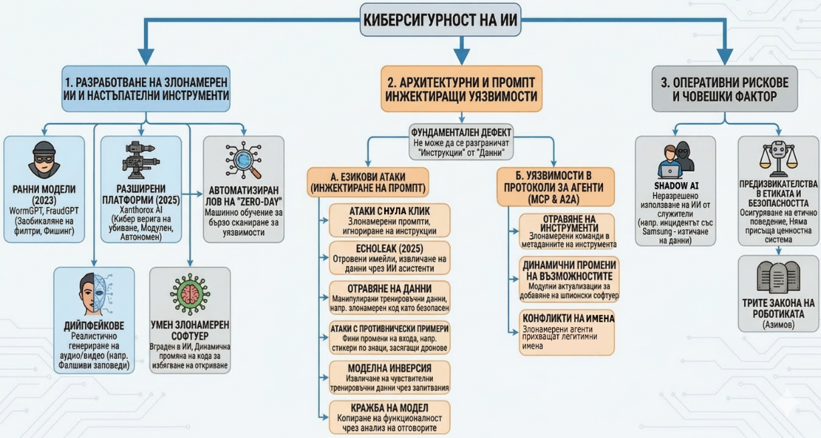
Фигура 65. Класификация на уязвимостите на AI Необходима редакция. Не мога да го редактирам нека остане така.
Сигурността на AI системите е динамично бойно поле. Еволюцията на заплахите изисква преминаване от реактивен към проактивен подход на защита, базиран на следните принципи:
– архитектурна изолация – използване на локално хоствани модели и изолирани агентни среди за работа с чувствителна информация, елиминирайки зависимостта от публични API;
– нулево доверие (Zero Trust) – всяка интеграция на AI агент трябва да бъде третирана като потенциално враждебна, със строг контрол на достъпа и валидация на инструментите;
– обучение и хигиена – персоналът трябва да бъде превърнат в „човешка защитна стена“ чрез обучение по промпт хигиена и разпознаване на манипулации;
– използване на търсачки като DuckDuckGo. Тя предлага услуги, без да събира история на търсене, вградени защити, като блокиране на реклами и блокиране на бисквитки, VPN, който предотвратява събирането на IP адреса от уебсайтове и предоставя Duck.ai, който предлага безплатен достъп до популярни чатботове, но с възможност да се ползват анонимно. Duck.ai не записва и не съхранява нито един чат, а разговорите не се използват за обучение на чат модели.
Бъдещето на отбраната принадлежи на тези, които не само използват силата на изкуствения интелект, но и разбират неговите фундаментални уязвимости – от невъзможността за разграничаване на данни от инструкции до рисковете от автономни агентни взаимодействия.